Почему нейросети ошибаются в перспективе: FLUX опередила новые модели
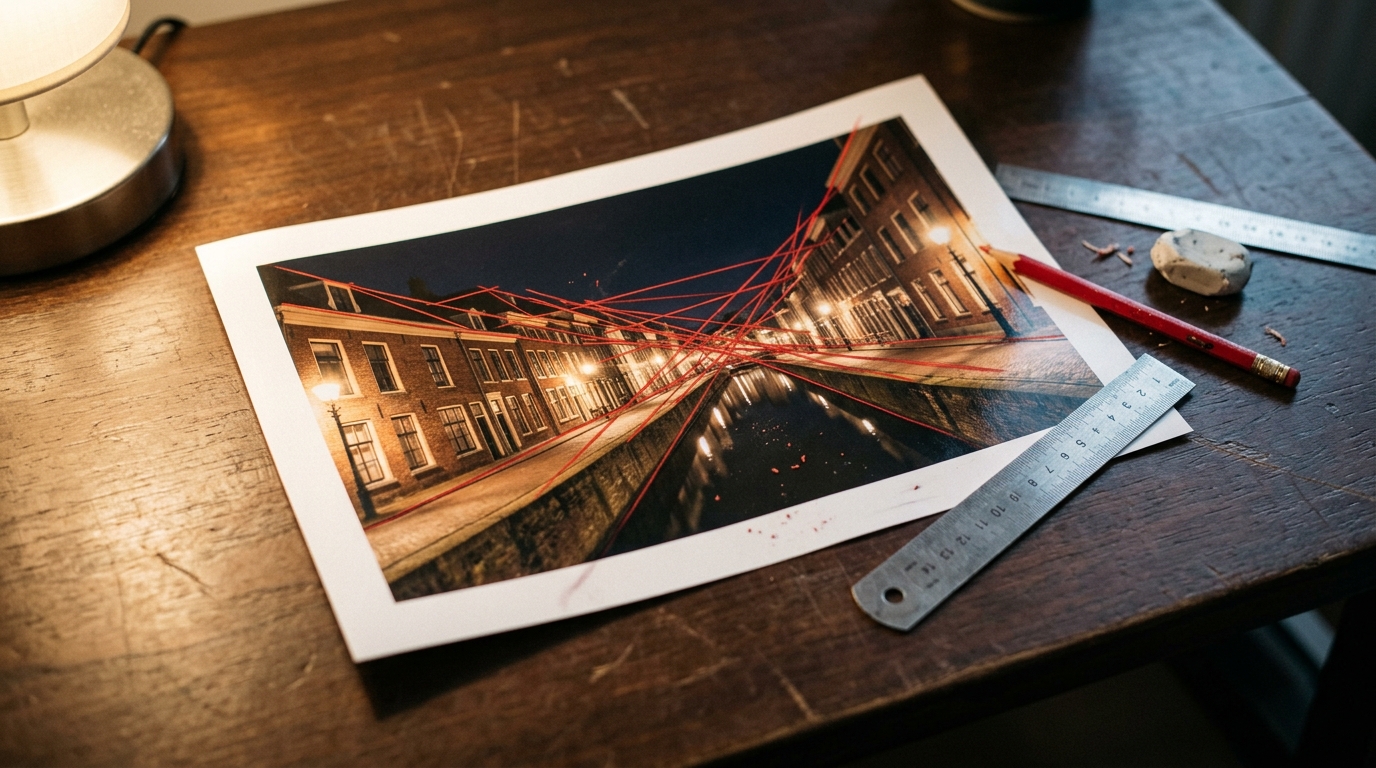
Генераторы изображений научились создавать убедительные сцены, но геометрия по-прежнему остаётся их слабым местом. Параллельные линии могут уходить в разные точки, стены и мебель — не совпадать по перспективе, а отражения — жить по собственным правилам. Тест семи моделей показал, что более новая версия не обязательно лучше справляется с этой задачей.
Лучший результат получила FLUX 1.1 Pro Ultra, выпущенная в ноябре 2024 года. В трёх сценах она набрала в среднем 95 баллов из 100. Nano Banana 2.1, представленная в октябре 2026 года, получила 86,7 балла, а GPT Image 2.5 Sunburst — 83,3. При этом первая Nano Banana оказалась точнее своей новой версии.
Почему нейросети нарушают перспективу
Камера формирует изображение по законам оптики: параллельные линии в реальном мире на фотографии сходятся в общей точке схода. У каждого направления есть своя точка, а точки схода горизонтальных линий располагаются на линии горизонта. Генератор изображений работает иначе: он восстанавливает сцену по множеству визуальных примеров и не обязательно строит её на основе явной трёхмерной геометрии.
Эту проблему исследовали задолго до появления современных моделей. В 2022 году эксперт по цифровой криминалистике Хани Фарид показывал, что у изображений DALL-E 2 линии пола и столешницы на кухнях могут сходиться в разных местах. Аналогичные ошибки встречались в отражениях и других элементах сцены. Исследователи Sony в 2023 году отмечали, что точность перспективы не является обязательным требованием при обучении латентных диффузионных моделей.
В работе Sony авторы добавляли в обучение геометрическое ограничение и добивались предпочтения результата перед изображениями Stable Diffusion 2 в 70% сравнений. Однако такой подход требует набора данных с размеченными точками схода. Работа, представленная на CVPR в 2024 году, также показала, что изображения, прошедшие стандартные детекторы, могут выдавать искусственное происхождение по линиям, полю перспективы и связи объектов с тенями.
Как проходил тест
В сравнении участвовали FLUX 1.1 Pro Ultra, Nano Banana 1, Nano Banana 2.1, GPT Image 1, GPT Image 2.5 Sunburst, Seedream 5.0 Pro и Ideogram 4.5. Для каждой модели использовали три текстовых сценария: ночную улицу у канала, длинный проход в супермаркете и кухню-столовую.
Каждый генератор создавал изображения без исходной фотографии. Затем по краям зданий, полок, плитки, столешниц и других объектов проводили линии и оценивали, насколько они сходятся в одной точке. Фотографии похожих сцен использовались как контрольные примеры. Оценка была визуальной, выполнялась одним человеком, а на каждую модель и сцену пришёлся один прогон 21 октября 2026 года. Поэтому результаты нельзя считать полноценным независимым бенчмарком: они показывают поведение моделей именно в этом наборе условий.
Результаты по моделям и сценам
- FLUX 1.1 Pro Ultra — 95,0 балла: улица 100, супермаркет 85, кухня 100.
- Nano Banana 1 — 91,7 балла: улица 100, супермаркет 100, кухня 75.
- Nano Banana 2.1 — 86,7 балла: улица 100, супермаркет 100, кухня 60.
- GPT Image 2.5 Sunburst — 83,3 балла: улица 80, супермаркет 90, кухня 80.
- Seedream 5.0 Pro — 80,0 балла: улица 85, супермаркет 95, кухня 60.
- Ideogram 4.5 — 80,0 балла: улица 50, супермаркет 100, кухня 90.
- GPT Image 1 — 61,7 балла: улица 60, супермаркет 85, кухня 40.
Самой простой сценой оказался супермаркет: средний результат составил 93,6 балла. Большое количество повторяющихся линий — стеллажи, швы плитки и ряды ламп — помогло большинству моделей сформировать убедительную структуру. На улице средний результат достиг 82,1 балла, хотя даже там две модели получили низкие оценки несмотря на прямое указание точки схода в промпте.
Кухня стала самым сложным испытанием: средний показатель снизился до 72,1 балла. Только FLUX 1.1 Pro Ultra свела все основные линии к одной точке и получила 100. У Nano Banana 2.1 результат составил 60 против 100 на улице, а GPT Image 1 набрала всего 40: стены и кухонный остров у неё указывали на разные точки схода.
Новые версии не всегда точнее
Сравнение моделей одного семейства дало разные результаты. Nano Banana 2.1 оказалась слабее первой версии — 86,7 против 91,7 балла. На улице и в супермаркете обе модели получили высокие оценки, но новая версия заметно потеряла на кухонной сцене: 60 против 75 баллов.
У GPT Image наблюдалась обратная картина. GPT Image 2.5 Sunburst набрала 83,3 балла против 61,7 у GPT Image 1, прибавив 21,7 пункта — это самый заметный рост в тесте. Новая версия улучшила результат на всех трёх сценах, особенно на кухне: с 40 до 80 баллов.
Авторы теста связывают часть различий с изменениями в архитектуре генераторов. Ранние диффузионные модели использовали U-Net, затем появились трансформерные подходы вроде DiT. Современные мультимодальные системы могут генерировать изображения внутри языковой модели, а некоторые модели дополнительно планируют композицию перед отрисовкой. Однако сами результаты не подтверждают, что предварительное рассуждение автоматически исправляет перспективу: в одной паре моделей оно совпало с улучшением, в другой — с ухудшением.
Главный практический вывод прост: при работе с интерьерами, архитектурой и обложками изображение стоит проверять по линиям перспективы независимо от названия и номера версии модели. Достаточно продлить несколько краёв пола, стен или мебели до пересечения. Такой быстрый тест помогает заметить ошибку до того, как картинка попадёт в макет, рекламный материал или визуализацию пространства.