Cloudflare разделит поисковых и обучающих ИИ-ботов для сайтов
Cloudflare представила механизм, который должен помочь владельцам сайтов разделять поисковых роботов и краулеры, собирающие контент для обучения ИИ-моделей. Идея решает давний конфликт: издатели хотят получать переходы из поиска, но не всегда готовы бесплатно отдавать материалы для создания ответов нейросетей.
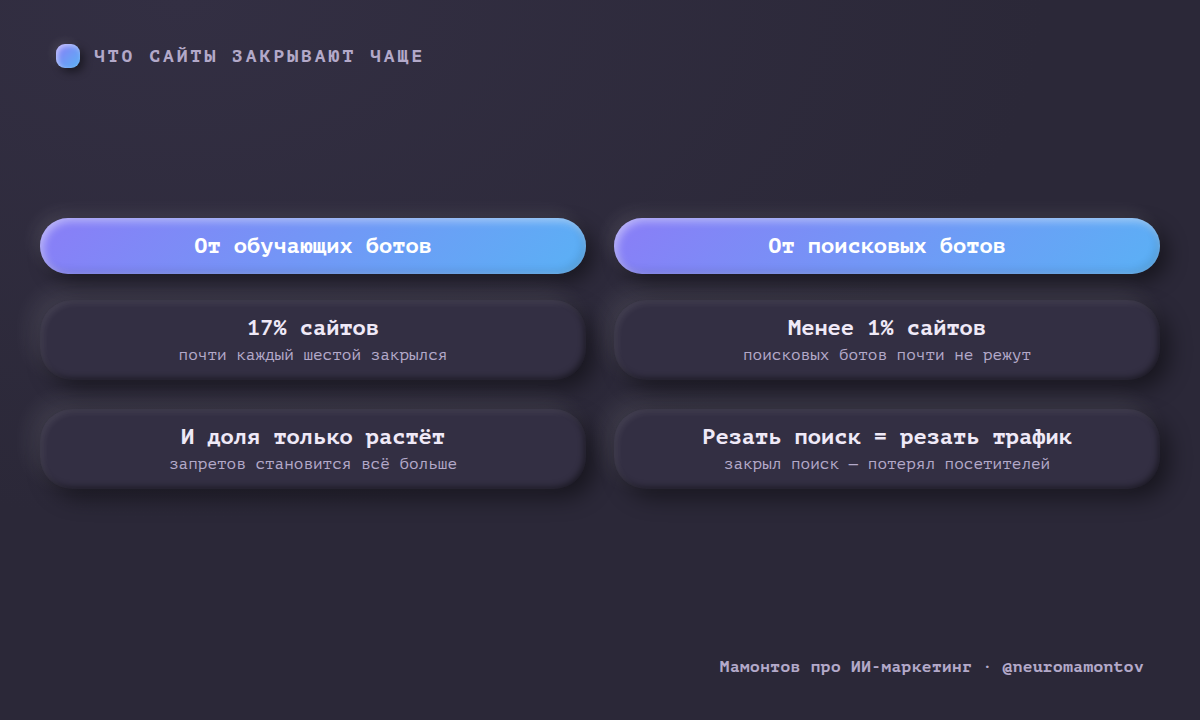
По оценке самой Cloudflare, в 2025 году около 17% сайтов пытались закрыться от обучающих ботов. При этом поисковых роботов блокировали менее 1% ресурсов. Разница объясняется экономикой: поисковая индексация обычно приводит пользователя на сайт, где работают реклама, подписки, реферальные программы и другие способы монетизации.
С обучающими краулерами ситуация иная. Модель может усвоить статью, факты и выводы, а затем пересказать их в собственном интерфейсе без перехода к оригиналу. Даже упоминание автора не компенсирует отсутствие трафика: созданный за счёт многолетней работы материал оказывается доступен пользователю бесплатно и вне площадки издателя.
Как Cloudflare предлагает разграничить роботов
Cloudflare обслуживает более 20% сайтов в мире и заявляет, что договорилась с большинством крупных операторов ИИ о соблюдении новых правил. Платформы, относящиеся к категории Accountable, должны поддерживать отказ от использования контента для обучения, обеспечивать прозрачность на уровне отдельных URL и не ухудшать поисковые позиции сайта из-за такого запрета.
В панели Cloudflare появились три категории поведения роботов: поиск, обучение и агенты. Для них предусмотрены четыре режима блокировки, включая отдельный вариант для страниц с рекламой. Технически настройки опираются на robots.txt: сайт может запретить использование страниц для обучения, сохранив доступ поисковым роботам.
Согласно заявлению Cloudflare, требованиям уже соответствуют Google и Apple. Microsoft планирует доработать поддержку в начале 2027 года. Ранее похожие ожидания связывали с форматом llms.txt, однако он не получил широкого распространения: часть провайдеров ИИ не стала соблюдать его директивы.
Почему механизм может работать неидеально
Главное ограничение заключается в том, что разделить задачи робота на стороне сайта технически невозможно. Один и тот же краулер может одновременно использоваться для поиска и сбора данных для обучения. User-Agent и IP-адрес не позволяют надёжно определить, с какой целью запрашивается конкретная страница.
В результате новая система во многом держится на добросовестности операторов и их готовности соблюдать заявленные правила. У владельца сайта по-прежнему нет универсального способа проверить, действительно ли запрещённый контент не используется при обучении модели.
Есть и другая проблема: материалы копируют не только разработчики ИИ. Существуют многочисленные парсеры, которые забирают статьи и публикуют их на сторонних ресурсах. Если обучающий робот не сможет обратиться к оригиналу, он всё ещё может найти тот же текст на сайте-копии, который не соблюдает ограничения.
Рынок ищет новую модель монетизации
Несмотря на ограничения, направление, выбранное Cloudflare, отражает реальную потребность рынка. Нейросетевые ответы меняют поисковое поведение пользователей и сокращают число переходов на сайты. Поэтому издателям нужны либо технические гарантии контроля, либо финансовая компенсация за использование их материалов.
В перспективе ценность оригинального человеческого контента может возрасти. ИИ-моделям необходимы свежие тексты, исследования и практический опыт: при обучении на бесконечных пересказах и синтетических публикациях качество ответов снижается. Поэтому индустрия постепенно ищет баланс между доступом моделей к данным и сохранением мотивации авторов создавать уникальные материалы.