Распознавание визиток на телефоне без облака: PaddleOCR, ONNX и React Native
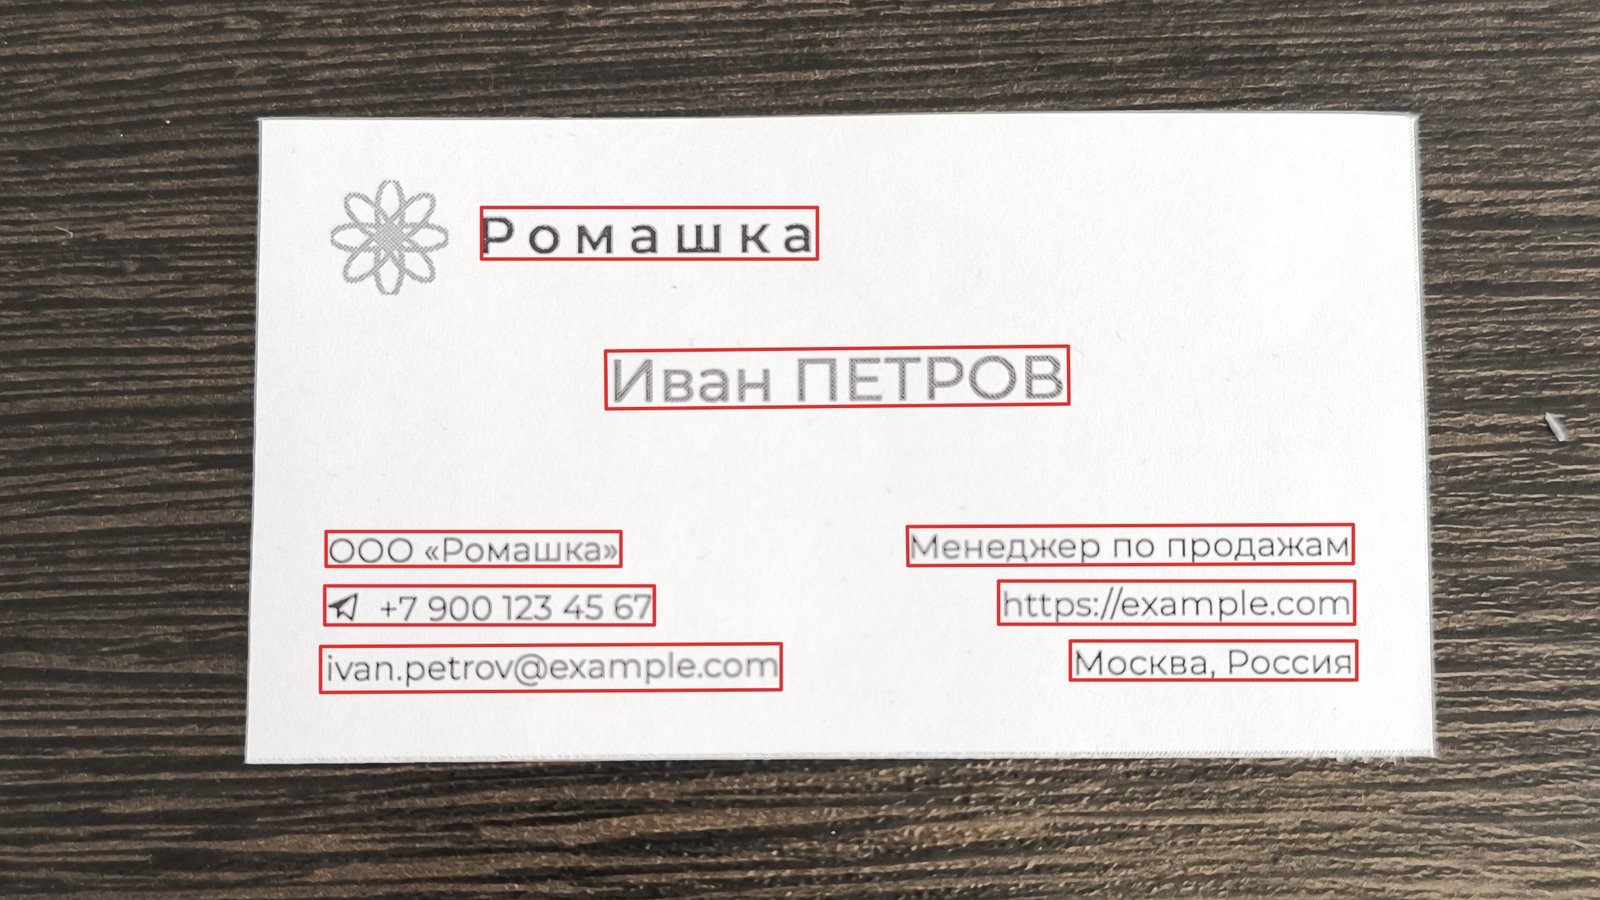
В мобильном приложении для обмена контактами на конференциях сначала использовались QR-коды, но во второй версии понадобилось распознавать бумажные визитки. Пользователь фотографирует карточку и получает контакт с отдельными полями: именем, компанией, телефоном, почтой и адресом.
На первый взгляд такую функцию можно быстро собрать на облачном OCR. Однако фотография визитки содержит персональные данные третьего лица. При отправке снимка на сервер разработчик становится оператором этих данных со всеми обязанностями по 152-ФЗ. Дополнительно возникают вопросы трансграничной передачи и поручения обработки. Поэтому было принято принципиальное решение: снимок не покидает телефон, а распознанные данные не отправляются на сервер.
У локальной обработки есть важное следствие: нельзя построить привычный цикл «пользователь исправил ошибку — модель дообучили». Обучающей выборки в приложении не будет, поэтому качество пришлось повышать за счёт выбора моделей, обработки изображений, правил разбора текста и аккуратных измерений.
Почему на Android понадобился собственный OCR
Приложение написано на React Native, но возможности платформ для кириллического OCR оказались разными. В iOS системный Vision поддерживает русский язык начиная с iOS 16 и не увеличивает размер дистрибутива. На Android в ML Kit доступны распознаватели для латиницы, китайского, деванагари, японского и корейского языков, но русского среди них нет.
Для Android выбрали мобильную комплектацию PaddleOCR v5: детектор строк PP-OCRv5_mobile_det и распознаватель eslav_PP-OCRv5_mobile_rec, обученный на восточнославянских языках. Модели конвертировали в ONNX и запускали через ONNX Runtime. В сумме они занимают 12,7 МБ.
Облачные сервисы отпали из-за требований к приватности, ML Kit — из-за отсутствия кириллицы. Локальные большие языковые и мультимодальные модели оказались неоправданными: для раскладки 6–15 строк по восьми полям не требуется рассуждение. LLM потребовала бы 125–800 МБ, несколько секунд работы на процессоре и до 1 ГБ памяти, а мультимодальная модель «фото — JSON» — около 2 ГБ и всё равно могла ошибаться в цифрах телефона. Gemini Nano формально не увеличивает дистрибутив, но доступен только на части флагманских устройств.
Один конвейер на TypeScript
После конвертации моделей отдельный Python-сервис для экспериментов оказался не нужен. Подготовка изображения, работа детектора, CTC-декодирование и раскладка строк по полям реализованы на TypeScript. На ноутбуке и в мобильном приложении используется один и тот же код, меняется только пакет исполнения: onnxruntime-node заменяется на onnxruntime-react-native.
В ходе интеграции обнаружилось несколько важных деталей. Модели ожидают каналы в порядке BGR, а не RGB. Размер входа детектора 960 оказался недостаточным для визиток, поэтому его увеличили до 1600. Растяжение контраста перед детекцией добавило 11 процентных пунктов к качеству. Для рамок строк пришлось самостоятельно реализовать unclip без pyclipper, а вертикальные строки перед распознаванием поворачивать на 90 градусов.
От строк к полям контакта
OCR возвращает не готовую визитку, а список строк с координатами и уверенностью. Ни Vision, ни ML Kit, ни PaddleOCR не объясняют, где имя, должность или название компании. Поэтому основная прикладная логика строится поверх результатов распознавания.
Телефон, почту и сайт можно находить регулярными выражениями. Для компании с юридической формой и адреса помогают маркеры и словари. Сложнее всего определить ФИО, должность и компанию без явных признаков. Здесь используются геометрия карточки, размер текста, положение и соседство строк, словари имён, фамилий и должностей, а также типографика.
Отдельный этап исправляет смешение кириллических и латинских символов. Например, модель может прочитать слово «Россия» как «Roссия», заменив кириллические буквы визуально похожими латинскими. Алфавит определяют по однозначным символам: «Ж» относится к кириллице, а «S» — к латинице. Если в слове нет таких букв, его не изменяют, чтобы не внести ошибку.
Другие дефекты исправляются уже при нормализации полей. Пропавшая кавычка в названии компании восстанавливается в форме «ООО Ромашка», а слипшиеся группы цифр телефона форматируются как «+7 900 123 45 67». Правило регистра тоже оказалось полезным: фамилия, набранная капсом среди слов с обычной заглавной буквы, чаще всего должна попасть в поле фамилии, а не имени.
Сайт может служить подсказкой для поиска названия компании. Домен и кириллическое наименование сначала приводятся к общим классам звучания, после чего принимается только точное совпадение. Мягкое сопоставление оказалось опасным: оно способно выбрать похожее, но неверное слово вместо корректно распознанного адреса.
Как измеряли качество без открытого датасета
Открытых наборов фотографий визиток практически нет, а русскоязычного набора найти не удалось. Реестры юридических лиц тоже не решают задачу: на карточке часто указан бренд, а юридическая форма встречается примерно на каждой пятой визитке. Поэтому для оценки собрали собственный набор из 193 снимков.
Каждую карточку проверяли в двух вариантах. В первом использовался обычный результат OCR, который увидел бы пользователь. Во втором текст тех же строк исправляли вручную. Это позволяло отделить ошибки распознавания от ошибок раскладки. На исправленном тексте ядро контакта — имя, фамилия, компания и телефон или почта — собиралось на 88% карточек. На живом OCR показатель составлял 44%, что указывало на распознавание как на главный узкий участок.
Правила заметно хуже обобщались на новые данные. На 47 снимках, использованных при их разработке, ядро контакта собиралось на 53% карточек, а на 59 незнакомых визитках — только на 25%. Более практичный критерий — правильное имя, узнаваемая компания и наличие телефона — дал 56%, а после добавления классификатора строк результат вырос до 63%.
На данных подгонки телефон распознавался в 100% случаев, почта — в 96%, имя и фамилия — в 94%, а компания — только в 57%. Основные потери приходились на названия, набранные декоративным шрифтом логотипа. При этом детектор находил название на 93% всех карточек и читал его буква в букву на 79% из них. Значит, проблема чаще была не в чтении логотипа, а в выборе нужной строки.
Классификатор не заменил правила: при кросс-валидации он давал от 28% до 54% против 60% у правил для компании. Признаки вроде доли заглавных букв и наличия слов, связанных с организацией, тянули модель к длинному юридическому названию, тогда как пользователю нужен бренд. В итоге классификатор оставили в узкой роли: он предлагает строку только тогда, когда после работы правил поле компании осталось пустым. Это добавило два процентных пункта без новых потерь.
Как сократили время обработки
Первая рабочая версия на среднем Xiaomi обрабатывала снимок примерно за 7,8 секунды, из которых 5,2 секунды занимал OCR пятнадцати строк. Наиболее заметное ускорение дало ограничение числа потоков ONNX Runtime. Автоматический запуск потока на каждое ядро приводил к большому разбросу — от 6,3 до 13,1 секунды. Два потока сократили время до 2,6–4,1 секунды, тогда как четыре потока работали не лучше настроек по умолчанию. Параметр intraOpNumThreads: 2 ускорил обработку примерно в 3,7 раза.
XNNPACK использовать не стали: после создания сессии он приводил к аварийному завершению процесса. Повторное распознавание строк, повернутых на 180 градусов, теперь запускается только для карточек, которые не удалось прочитать с первого раза. Это сократило время с 7,1 до 4,7 секунды. Один найденный телефон не считается достаточным признаком правильной ориентации: цифры могут читаться и вверх ногами.
Отдельная оптимизация касалась обработки пикселей в JavaScript. Функция выборки пикселя создавала стрелочное замыкание при каждом вызове, а при ресайзе выполнялись миллионы таких операций. На Hermes, где нет оптимизирующего JIT, это увеличило время изменения размера изображения 4000×3000 с 91 до 5084 миллисекунд. После устранения замыканий правило стало простым: в горячих циклах по растрам нельзя создавать функции и использовать лишние операции вроде map.
Даже арифметически эквивалентные формулы интерполяции могли давать разные значения в последнем бите. При записи в Uint8Array значение 231,999999 усекалось до соседнего уровня яркости вместо 232. Ошибку обнаружил тест, сравнивавший пиксели с прямолинейной реализацией; без него качество могло незаметно измениться на всём наборе.
Быстрый проход детектора на изображении шириной 640 пикселей позволяет найти область карточки, после чего основной детектор работает с кропом. Это дало сокращение времени примерно с 4,7–5,8 до 2,9–3,6 секунды. Но обрезка влияет на весь ответ модели: из-за GlobalAveragePool и блоков squeeze-and-excitation рамки строк могут сместиться на 1–4 пикселя даже далеко от краёв. Поэтому кроп применяют только если карточка занимает больше 55% кадра.
Пакетное распознавание строк оказалось невыгодным: оно ускоряло обработку на 8%, но на десяти карточках потеряло 13 полей. Дополнение строк нулями до размера соседней строки сильнее меняло результат модели, чем ожидалось. Увеличение разрешения выше 1600 пикселей также не помогло: выигрыш по качеству отсутствовал, а декодирование JPEG становилось дороже — до двух секунд для изображения 2400 пикселей и до 36 МБ памяти под растр.
Память, размер приложения и телеметрия
Арена памяти ONNX Runtime у детектора удерживала около 550 МБ до завершения процесса. Это не выглядело утечкой: между снимками память не росла, но приложение оставалось тяжёлым. Арену отключили только у детектора, снизив потребление в простое примерно с 800 до 410–470 МБ. Цена решения — около 0,1 секунды на снимок; серия из 11 кадров проходила без постепенного замедления.
Троттлинг нельзя было надёжно оценивать по thermal status: этот показатель оставался нулевым, когда большие ядра уже снижали частоту с 2,8 до 1,8–2,2 ГГц. Для диагностики пришлось смотреть именно на реальные частоты процессора.
До добавления OCR arm64-версия APK занимала 27,1 МБ, после интеграции — 39,8 МБ. Собственная сборка ONNX Runtime только с необходимыми операторами сократила размер до 32,5 МБ. Корректность проверяли не только по заполненным полям, но и побайтовым сравнением выхода конвейера на 205 кадрах.
При тестировании iOS выяснилось, что ONNX Runtime по умолчанию отправляет телеметрию. В сетевом логе после распознавания появлялись два POST-запроса к инфраструктуре Microsoft. Для сценария, который должен работать без сетевых обращений, это неприемлемо. Телеметрию отключили до создания окружения ONNX Runtime и после этого вызвали отключение событий, закрепили нативную версию библиотеки во всех местах сборки, а Android-версию собрали с флагом no_telemetry. Проверять результат пришлось сетевым логом, поскольку в отладочных сообщениях факт отправки не отображался.
Главный вывод проекта — локальный OCR визиток состоит не только из выбора модели. В готовом продукте одинаково важны приватность, корректная подготовка изображения, разбор строк по геометрии и правилам, измерение на новых карточках, контроль памяти и проверка сетевой активности библиотек. Для задачи с небольшим числом полей специализированный OCR и детерминированная логика оказались практичнее больших языковых моделей, а основные улучшения дали не новые нейросети, а точные тесты и профильные оптимизации.