ИИ посадили за руль реального автомобиля: что показал эксперимент
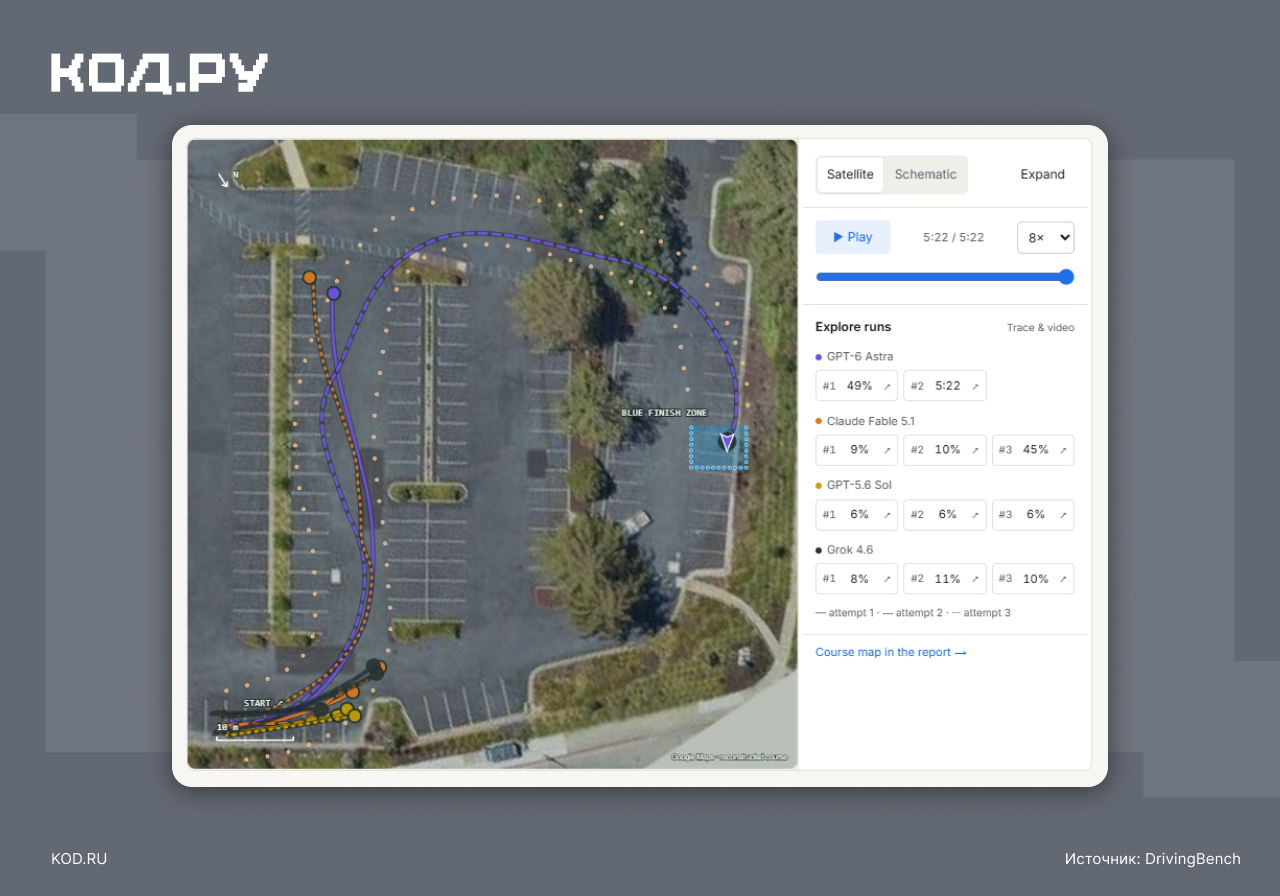
Исследователи проекта DrivingBench провели эксперимент, чтобы выяснить, насколько современные универсальные ИИ-агенты способны управлять настоящим автомобилем. В отличие от симуляторов, тест проходил в физическом мире — с реальными задержками передачи данных, обработки изображения и выполнения команд.
Для испытаний использовали седан Toyota Corolla 2022 года. Машиной управляли через устройство Comma Four с открытой системой Openpilot, подключённое напрямую к CAN-шине автомобиля. Такая конфигурация позволила передавать модели команды управления и получать данные о происходящем на дороге.
Как был устроен эксперимент
Основой системы стал ноутбук, подключённый к мобильной точке доступа. Изображения с двух дорожных камер и телеметрия автомобиля поступали через локальный MCP-сервер в чат с языковой моделью. ИИ-агенты могли использовать три инструмента: наблюдать за окружающей обстановкой, задавать угол поворота руля и скорость на определённый промежуток времени либо активировать экстренное торможение.
Тесты проводили на изолированной парковке с дополнительными мерами безопасности. Скорость программно ограничили диапазоном от 0,5 до 3,5 м/с, то есть примерно до 13 км/ч. На водительском месте всё время находился оператор, который контролировал ситуацию и держал ногу над педалью тормоза.
Маршрут протяжённостью около 130 метров обозначили конусами. Он включал прямые участки, левые и правые повороты, а также зону для остановки и парковки в конце дистанции. Каждой модели давали до трёх попыток в рамках одного диалога. После неудачного заезда агенту предлагали проанализировать ошибку — это позволяло проверить, может ли модель корректировать поведение в пределах текущего контекста.
Результаты моделей
Полностью пройти трассу смогла только GPT-6 Astra. Со второй попытки она преодолела маршрут примерно за пять минут, а в первом заезде добралась до середины дистанции.
Другие участники показали заметно более слабые результаты. Claude Fable 5.1 в лучшей из трёх попыток прошла 45% маршрута. Grok 4.6 достиг 11%, а GPT-5.6 Sol смогла преодолеть только 6% дистанции.
Основной причиной сходов стали ошибки восприятия и пространственной оценки. Модели путали стороны конусной разметки, неправильно определяли габариты автомобиля по изображениям с камер и иногда делали слишком длинные паузы между управляющими командами. Эти задержки приводили к тому, что автомобиль продолжал движение дольше, чем требовалось для прохождения поворота или остановки.
Создатели DrivingBench считают, что эксперимент подтвердил принципиальную возможность управления автомобилем универсальными нейросетями на малой скорости. При этом до стабильной работы в реальных дорожных условиях таким системам ещё далеко: им необходимо уменьшить задержки между наблюдением и действием, а также улучшить пространственное планирование и оценку размеров окружающих объектов.