Исследователи выявили языковые особенности Opus 5.5 и других ИИ-моделей
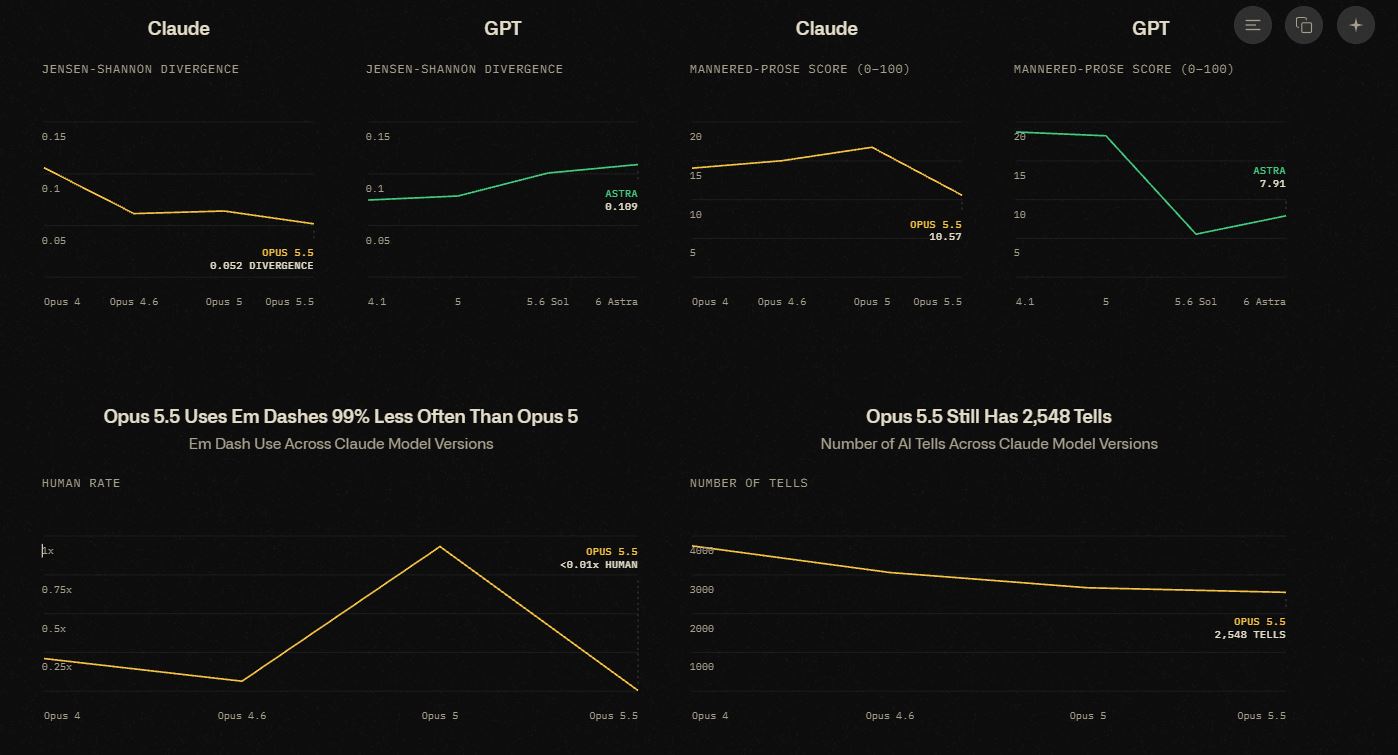
Маркетинговая компания Graphite изучила языковые привычки современных больших языковых моделей и выяснила, какие слова, фразы и конструкции они используют чаще всего. Исследователи обнаружили около 13 000 выражений, которые встречались в текстах, созданных ИИ, как минимум вдвое чаще, чем в материалах, написанных людьми.
Авторы работы отмечают, что разработчики заметно сократили распространённую ранее любовь моделей к длинным тире. При этом другие особенности стиля никуда не исчезли: модели по-прежнему часто используют конструкции с противопоставлением и формулировки, характерные именно для конкретной версии.
Как проводилось исследование
Для сравнения Graphite сформировала контрольную группу из 10 000 статей, опубликованных до выхода ChatGPT. Эти материалы использовали как образцы человеческого письма. Затем исследователи предложили разным ИИ-моделям переписать те же статьи на основе аннотаций, чтобы по возможности уменьшить влияние исходной стилистики.
После этого специалисты сопоставили тексты людей и результаты работы каждой модели. Они анализировали не только частотность отдельных слов и фраз, но и более общие закономерности построения предложений. По словам главного специалиста Graphite по искусственному интеллекту Грега Друка, модели Claude со временем приближаются к человеческому распределению слов, тогда как модели GPT, напротив, от него удаляются.
Чем отличаются разные модели
Наиболее характерным словом для Claude Opus 5.5 исследователи назвали «надёжный». В текстах этой модели оно встречалось в 23 раза чаще, чем в человеческих примерах. Opus 5.5 стала реже использовать конструкцию «это не X, это Y», но сохранила схожую форму противопоставления — «больше, чем X, это Y».
Модель также часто подчёркивает значимость обсуждаемого предмета. Фраза «это важно» встречалась в её текстах в 116 раз чаще человеческой нормы, а конструкция «почему X важно» — в 92 раза чаще. По мнению Graphite, такие повторяющиеся обороты могут становиться своеобразными стилистическими маркерами конкретной модели.
У Astra от OpenAI обнаружился другой набор особенностей. Модель часто говорит о «другом измерении» темы и избегает прямых утверждений, используя осторожные формулировки вроде «может обеспечить». Ещё один заметный признак — корректирующие конструкции: «не просто X» или «вместо того чтобы полагаться на X». По данным исследования, они встречались в текстах Astra более чем в 100 раз чаще, чем в человеческом письме.
Длинных тире стало меньше, но характерные признаки остались
Все крупные разработчики, судя по результатам анализа, отреагировали на критику чрезмерного использования длинных тире. В образцах Graphite Opus 5.5 применяла этот знак препинания на 99% реже, чем предыдущая версия Opus. Astra использовала его на 88% реже, чем авторы-люди, а Gemini 3.1 Pro практически исключила длинные тире из текстов.
При этом общее количество заметных стилистических признаков в основном сохраняется. Как пояснил Друк, разработчикам удаётся устранять наиболее известные особенности, однако на их месте появляются новые. Каждая версия модели формирует собственный набор повторяющихся слов и речевых конструкций.
Anthropic при выпуске Opus 5.5 заявляла, что модель общается естественнее предыдущих версий, а первые пользователи считают её тексты более ясными и понятными. OpenAI делала похожие заявления о версиях Sol и Luna на базе GPT-6, обещая меньше жаргона, больше ясности и меньше необычных оборотов.
В Graphite сомневаются, что лаборатории способны полностью контролировать такие особенности. По словам Друка, речь идёт о моделях с миллиардами параметров, которые невозможно проверить по всем возможным сценариям. Поэтому даже после целенаправленной настройки в текстах остаются устойчивые шаблоны, не всегда заметные разработчикам.
Параллельно эксперты обращают внимание на то, что ИИ-модели начинают формировать собственные необычные способы общения. Этот стиль описывают как смесь языка Джеймса Джойса из «Поминок по Финнегану» и технического жаргона. Модели крупных разработчиков создают новые сочетания, сокращения и значения слов, которым их напрямую не обучали. Такой трудно понимаемый язык усложняет контроль над системами и может создавать дополнительные риски при их использовании.