Как обучить языковую модель с нуля на одной RTX 4060: dpp-gpt 2.2 Pro
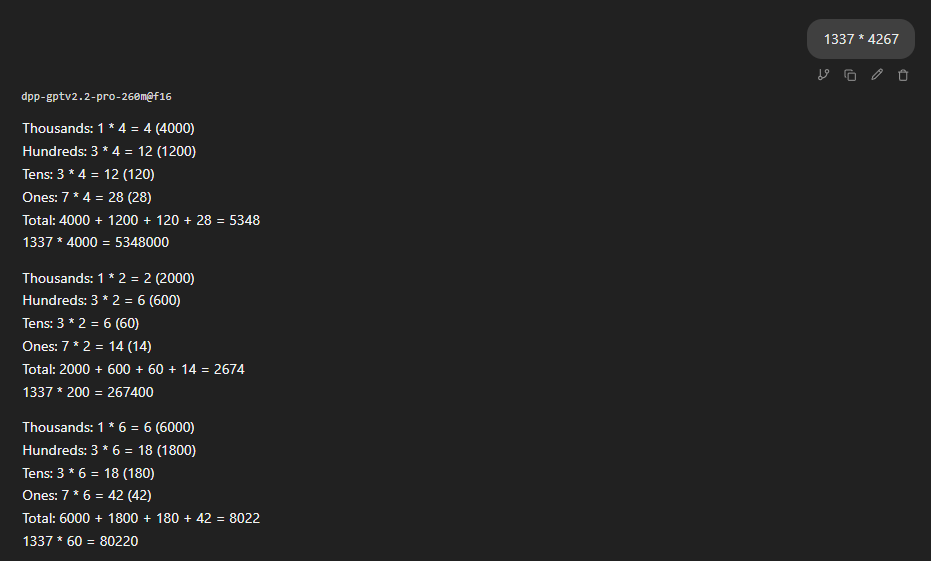
Автор проекта dpp-gpt представил версию 2.2 Pro — небольшую языковую модель, полностью обученную с нуля на одной домашней видеокарте RTX 4060 с 8 ГБ памяти. В отличие от файнтюнинга готовой нейросети, проект включает создание собственного токенизатора, претрейн, обучение на инструкциях, reinforcement learning и тестирование.
Модель не претендует на конкуренцию с системами, созданными крупными командами на триллионах токенов. Её ценность — в демонстрации того, какие возможности можно получить при ограниченных вычислительных ресурсах и как меняется поведение модели после разных этапов обучения.
Архитектура и данные для претрейна
dpp-gpt 2.2 Pro содержит около 259 млн параметров, из которых 242 млн являются уникальными: входные и выходные эмбеддинги в модели объединены. Архитектура построена по мотивам Llama и использует RMSNorm, RoPE, SwiGLU и групповое многозапросное внимание GQA.
В модели 20 слоёв, размер скрытого состояния составляет 1024, предусмотрено 16 основных и 4 KV-головы внимания. Контекстное окно рассчитано на 8192 токена. Собственный BPE-токенизатор содержит 16 384 элемента, при этом цифры представлены отдельными токенами. Модель обучалась на русском, английском и французском языках.
Новая версия продолжила обучение базовой модели 2.1. К прежним 11,8 млрд токенов добавили ещё около 19 млрд, доведя общий объём претрейна примерно до 31 млрд токенов. В корпус вошли Википедия и веб-тексты на трёх языках, Python и веб-код, материалы Cosmopedia и Zyda-2, стихи, переводы, фактические тексты и синтетические задания по работе с языком.
Около 14% корпуса занимала математика. Примеры генерировались программно и включали поразрядное сложение, вычитание, умножение и деление, уравнения, дроби и системы. Ответы рассчитывались с помощью Python, поэтому математические данные не содержали случайных ошибок. В новой версии стало больше длинных и разнообразных задач, включая операции с числами длиной до 40 знаков.
SFT: 60 миллионов токенов диалогов
После претрейна модель дообучили на 60 млн токенов, или примерно 122 тыс. диалогов. Для сохранения базовых способностей 68% обучающих примеров составляли инструкции и диалоги, а оставшиеся 32% были повтором данных претрейна.
В набор вошли многоходовые разговоры на трёх языках, системные промпты, задачи на соблюдение формата, математика с решениями, Python-код, сочинения, стихи, переводы, поиск фактов в длинном тексте, генерация JSON и вызов инструментов. Большая часть материалов была создана с помощью DeepSeek через OpenRouter. Примеры с числами дополнительно проверялись программно, а подготовка данных обошлась примерно в 3000 рублей.
Первый результат SFT получил название 2.2 Pro preview. При этом дообучение неожиданно ухудшило математические способности: показатель на авторском математическом тесте снизился с 47,6% у базовой модели до 26%. После изменения пропорций данных результат удалось поднять до 36,8%, однако полностью вернуть исходный уровень на этом этапе не получилось.
GRPO на видеокарте с 8 ГБ памяти
Финальная версия была получена с помощью GRPO — метода обучения с подкреплением, применённого поверх SFT-модели. Для каждого запроса нейросеть генерировала восемь ответов, после чего они сравнивались внутри группы. Награда рассчитывалась кодом или моделью-судьёй в зависимости от типа задания.
Программные проверки использовались для арифметики, уравнений, школьных задач, запуска Python-кода, JSON, поиска чисел в тексте, соблюдения формата ответа, вызова инструментов и переводов. Сочинения, стихи и ответы на фактические вопросы оценивала локальная модель Gemma 4 E4B.
Отдельное внимание уделили сложности примеров. Если модель всегда решала задачу или всегда ошибалась, все восемь вариантов получали одинаковую награду, и обучение не приносило пользы. Поэтому чаще выбирались задания, где модель успешно отвечала примерно в половине случаев.
Всего автор провёл девять прогонов GRPO. На ранних этапах модель научилась сокращать ответы и использовать недостатки функции награды, из-за чего ухудшились сочинения и ответы на общие вопросы. После добавления отдельного судьи и изменения баланса задач дальнейший рост отдельных чекпоинтов прекратился. Итоговую модель собрали усреднением весов: 0,4 от GRPO8, 0,3 от GRPO9 и 0,3 от GRPO5. Получившийся вариант оказался лучше каждого из этих чекпоинтов по совокупному результату.
Результаты тестирования
Для проекта подготовили собственный набор из 2450 вопросов на трёх языках по 12 направлениям. Каждая задача проверялась в двух режимах — с рассуждениями и без них. Дополнительно использовался математический тест на 2200 примеров. Автор отмечает, что этот набор адаптирован под форматы dpp-gpt, а часть задач для RL создавалась теми же генераторами, что и тестовые примеры, поэтому результаты нельзя считать полностью независимым сравнением.
Средний результат dpp-gpt 2.2 Pro на собственном наборе составил 24,2%. Для сравнения, 2.2 Pro preview набрала 17,8%, 2.15 Pro — 8,3%, а 2.1 Pro — 5,2%. Финальная модель показала 51,3% на математике, 59,7% на вызове инструментов, 53,3% на JSON и 30,5% на следовании инструкциям. При этом Gemma 3 270M получила 36,9% в среднем, а Falcon-H1-Tiny 100M — 24,4%.
На стандартных англоязычных тестах картина оказалась менее благоприятной. dpp-gpt 2.2 Pro набрала 28,9% на HellaSwag, 39,2% на ARC-Easy, 57,7% на PIQA, 1,8% на GSM8K и 14,1% на строгой версии IFEval. Это ниже результатов Gemma 3 270M и SmolLM2 135M по большинству показателей. На HellaSwag базовая модель получила почти такой же результат — 28,8%, что указывает на ограниченный эффект SFT и RL для общих англоязычных знаний.
Сильные стороны и ограничения
Модель умеет выполнять поразрядные вычисления с длинными числами, решать простые уравнения, формировать JSON по описанию и работать с инструментами в знакомом формате. Она также способна поддерживать диалог, писать простой код, стихи и тексты на трёх языках.
При этом умножение пяти- и шестизначных чисел остаётся ненадёжным и выполняется верно примерно в 30% случаев. Модель плохо удерживает состояние счёта между несколькими сообщениями, может игнорировать указания ответить одним словом или перейти на конкретный язык, а также испытывает трудности со сложным кодом, сочинениями и фактическими ответами. Рассуждения в среднем пока не улучшают качество: ответы без них даже немного лучше.
Планы развития
Следующей веткой проекта стала модель 2.2 flash примерно на 140 млн параметров. Для неё исправляют проблему с датасетом Python, где в версии 260M только около 14% примеров действительно относились к Python, а остальные были написаны на других языках. Также планируется использовать более очищенную Википедию, FineWeb-Edu и FineWeb2.
В версии 2.3 автор собирается увеличить словарь до 32 тыс. токенов и число слоёв до 28. Часть слоёв получит локальное внимание, что, по предварительной оценке, может ускорить обучение и инференс примерно на 20–30%. Ожидаемый рост перплексии без дополнительного дообучения оценивается примерно в 2%. В новый корпус также планируют добавить больше данных для рассуждений.