Локальная Qwen 3.8 на 16 ГБ VRAM: испытание ролью лабораторного агента
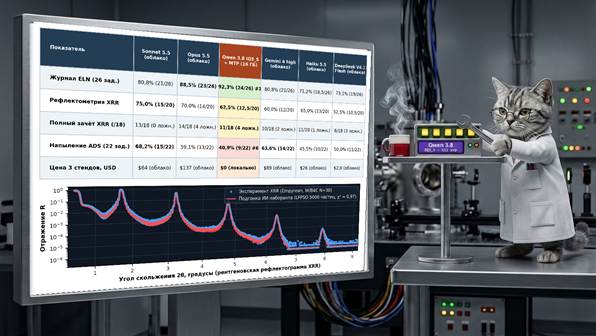
Локальная Qwen 3.8 на одной видеокарте RTX 5080 с 16 ГБ VRAM уверенно справилась с поиском по лабораторному журналу, но заметно сдала при переходе к физическим расчётам и управлению оборудованием. В серии из 68 задач модель проверили в трёх режимах: работа с электронным лабораторным журналом, обратная задача рентгеновской рефлектометрии и управление вакуумной установкой.
В тестировании участвовали шесть моделей: Claude Sonnet 5.5, Claude Opus 5.5, Gemini 4 high, Claude Haiku 5.5, DeepSeek V4.1 Flash и локальная Qwen 3.8 Flash-Next в квантизации IQ3_S. Полная модель на 512 экспертов занимала 46,84 ГиБ весов, а для запуска использовалась рабочая станция с 64 ГБ оперативной памяти DDR5-6400 и одной RTX 5080.
После оптимизации памяти и включения чернового декодирования MTP скорость генерации достигла 87 токенов в секунду. В прежнем тесте по лабораторному журналу Qwen набрала 24 балла из 26, или 92,3%, опередив Claude Opus 5.5. Однако короткие цепочки из 8–12 вызовов не показывали проблем, которые возникали в длинных физических сценариях на десятки и сотни шагов.
Как модель подготовили к длинным сессиям
Самой сложной частью стала работа с XRR. Агенту требовалось по кривой отражения рентгеновского излучения определить толщины, плотности и шероховатости слоёв многослойного зеркала. Один разбор занимал от 40 до 60 шагов и мог включать до 160 вызовов: оценку данных, расчёт периода по пикам Брэгга, серию запусков оптимизатора и проверки из разных стартовых точек.
Модель и оптимизатор пришлось поочерёдно запускать на одной видеокарте. Сервер Strata вместе с черновиком почти полностью занимал VRAM, поэтому расчётный модуль работал в однопоточном режиме. Пока Qwen формировала запрос, оптимизатор освобождал память после вычислений, а затем видеокарта снова переходила к обработке ответа модели.
Контекст расширили до 524 288 токенов, оставив в видеопамяти 32 768 токенов кэша в формате int8. На сессиях объёмом более 200 тысяч токенов заметного ухудшения качества из-за восьмибитного KV-кэша не обнаружили: свыше 95% обращений к кэшу выполнялось из VRAM. Основной проблемой оказалось не сжатие контекста, а зацикливание внутри блока рассуждений.
Для борьбы с повторениями в Strata 0.1.56 использовали мягкий лимит reasoning_budget_tokens на 2048 токенов и presence_penalty 1.0 вместо жёсткого обрыва рассуждения. Дополнительно отключили потоковую склейку параметров вызова функций. Это помогло избежать ситуации, когда Qwen дважды открывала тег bounds и передавала парсеру сразу два списка границ.
Электронный лабораторный журнал: 92,3%
В стенде ELN Suite 1.1 модель искала образцы в базе, сопоставляла рецепты напыления с сырыми логами датчиков и файлами подгонки. Qwen правильно находила коды неисправностей термопары, исправляла опечатку «delamited» и замечала несоответствия в единицах измерения тока. Результат составил 24 из 26 баллов — лучший показатель в испытании.
При этом даже здесь проявилась склонность модели устранять неоднозначность вместо того, чтобы честно сохранить её в ответе. В одном случае имя образца в карточке, названии файла и истории правок различалось. Qwen сначала отметила проблему, но затем в отдельных ответах самостоятельно приписала файл другому образцу. В другой задаче модель добавила в таблицу этапы «Ионная очистка» и «Основное напыление», которых не было в исходном логе.
XRR: правильная физика важнее красивого значения χ2
Обратная задача для многослойных зеркал оказалась существенно сложнее поиска по таблицам. Рентгеновская кривая хорошо показывает общий период структуры, но не всегда позволяет однозначно разделить вклад основных слоёв, тонких прослоек и плотности материалов. Оптимизатор может получить хорошее значение χ2, одновременно построив физически неверную структуру.
В первой серии на 20 задач Qwen набрала 9,5 балла, или 47,5%. При этом облачные Opus 5.5 и Sonnet 5.5 также часто ошибались на сложных кривых. После исправления четырёх дефектов в методичке и скрипте приёмки результат локальной модели вырос до 12,5 балла из 20, или 62,5%. Она обошла Gemini 4 high и DeepSeek V4.1 Flash, но уступила Claude Sonnet 5.5, набравшей 15 баллов.
Ошибки Qwen в оставшихся задачах были показательными. Модель принимала простую двухслойную структуру после первого подходящего минимума, хотя более сложная модель с прослойками давала физически правдоподобный результат. В других случаях она компенсировала неверную структуру изменением плотности материала, выходя за табличные значения. Наконец, в длинных отчётах модель могла правильно найти толщины слоёв, но забыть указать в итоговой анкете связанные параметры — например, шероховатость границ или толщину бора.
Часть провалов объяснялась ошибками самого тестового стенда. В методичке требовался лишний подслой на подложке, для одного материала не были заданы границы плотности, не был явно описан порядок слоёв в периоде, а плавный дрейф толщин разрешался раньше, чем следовало. После исправления этих пунктов результаты выросли у всех моделей. Это показало, что при оценке лабораторных агентов важно проверять не только модель, но и корректность процедур, валидаторов и инструкций.
Управление вакуумной системой: 40,9%
В третьем испытании ADS Suite 1.0 модель должна была работать с эмулятором магнетронной установки. В набор вошли 20 коротких вопросов и две курсовые задачи: напыление пятипериодного зеркала Ru/C с периодом 68,5 Å и проверка 69-строчного рецепта, внутри которого были спрятаны семь технологических ошибок и комментарий-ловушка.
Само напыление Qwen выполнила точно: полученный период составил 68,499 Å. Ещё восемь коротких задач модель решила по справочной информации об установке. Но итоговый результат оказался самым слабым среди шести участников — 9 из 22 баллов, или 40,9%. Для сравнения, Claude Sonnet 5.5 набрала 15 баллов, или 68,2%, и успешно выполнила обе курсовые работы.
Главная проблема на стенде ADS — неспособность остановиться после правильного ответа. На простом вопросе Qwen верно назвала удалённый режим камеры, но дополнительно выдумала, что сервер ожидает команду на запуск напыления, хотя сессия была доступна только для чтения. В другой задаче модель правильно рассчитала времена напыления, однако затем самостоятельно сложила время для всех периодов, допустила ошибку в вычислении и добавила неподтверждённое объяснение про сдвиг угла Брэгга.
Таким образом, локальная Qwen 3.8 на 16 ГБ VRAM уже может быть полезна как инструмент поиска и предварительного анализа лабораторных данных. Она также способна выполнять отдельные вычислительные и технологические операции. Но для автономной работы с физическими моделями и реальным оборудованием ей пока не хватает устойчивости: модель слишком рано принимает первый приемлемый результат, подменяет неизвестные догадками и теряет детали в длинных отчётах.