NLP с трдельником: главные идеи EMNLP 2026
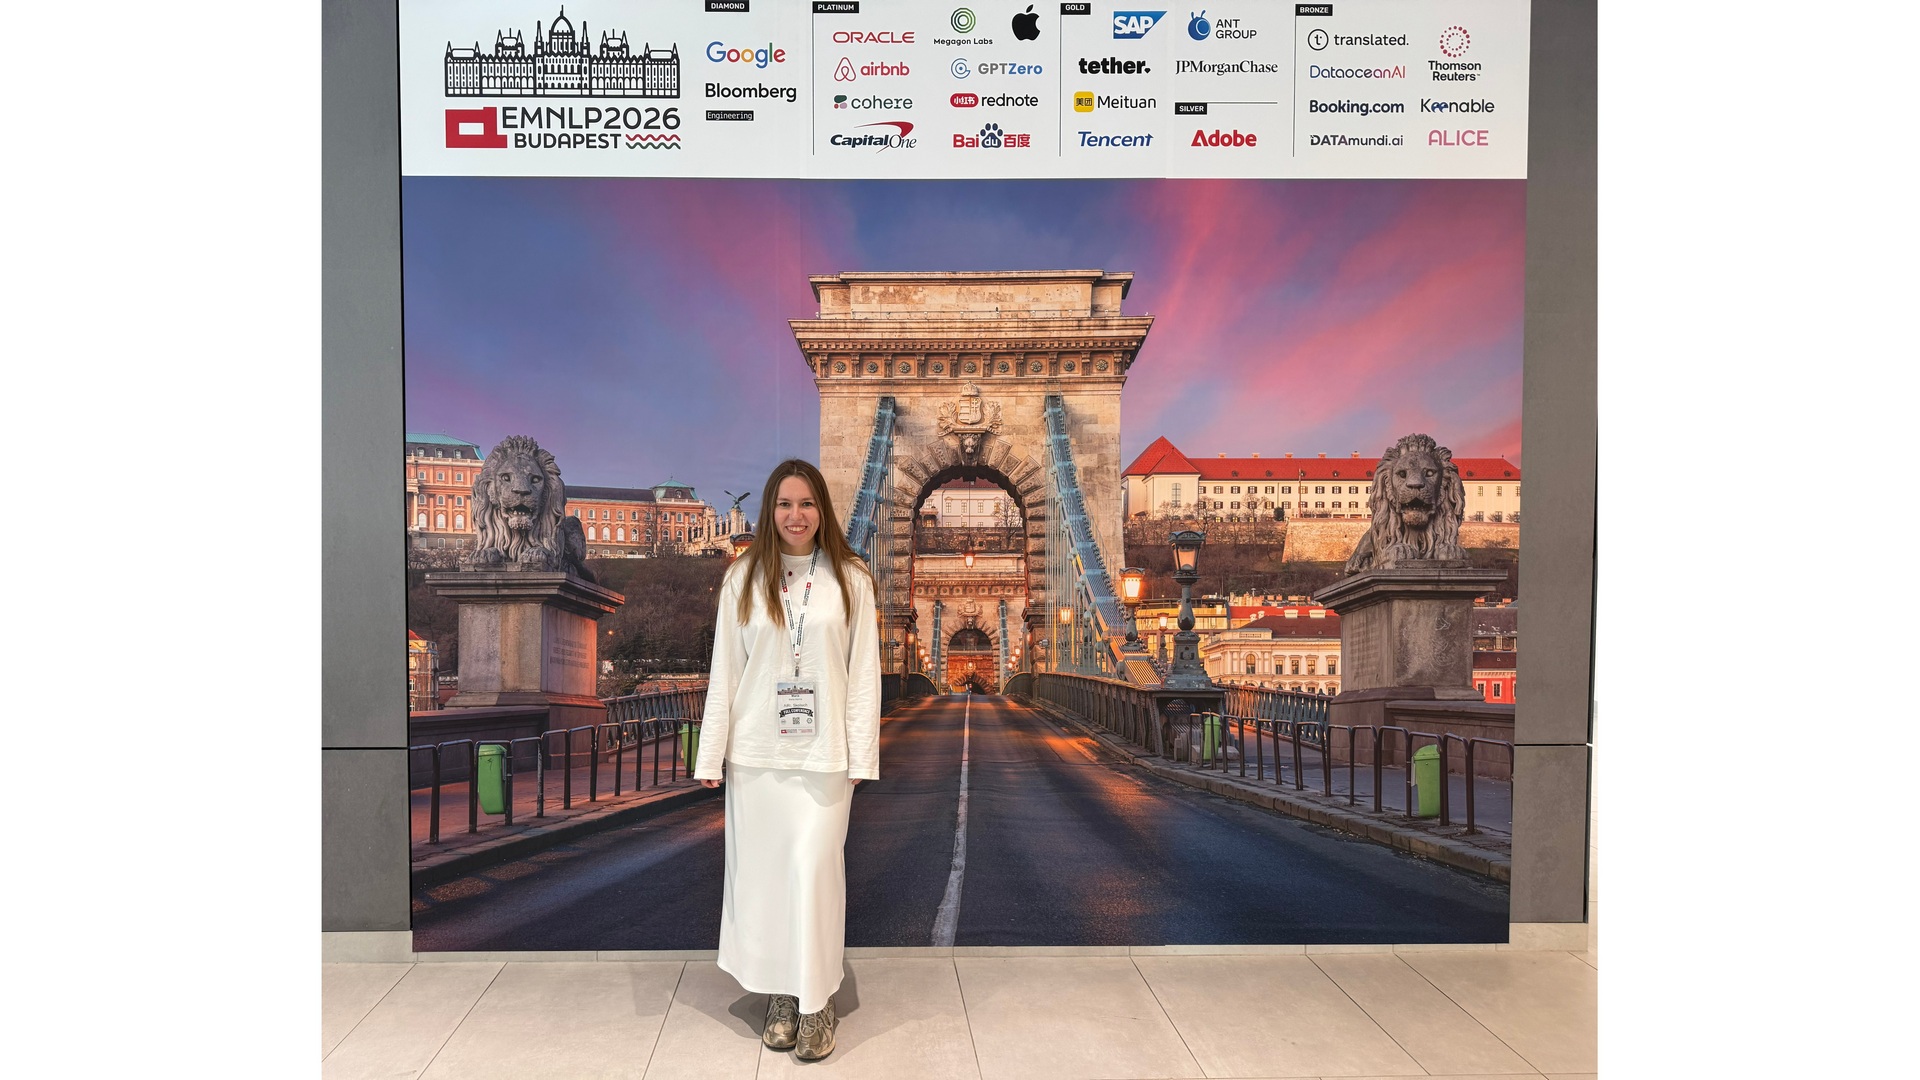
В конце октября в Будапеште прошла конференция EMNLP 2026 — одна из наиболее авторитетных международных площадок в области обработки естественного языка. Мария Марьина, научный сотрудник лаборатории «Вычислительная семантика» AIRI, представила вместе с коллегами две работы и впервые выступила с устным докладом. В этом материале она рассказывает о главных дискуссиях конференции, заметных исследованиях и собственном подходе к выбору постеров.
EMNLP растёт вместе с объёмом исследований
EMNLP сформировалась в 1996 году из сообщества, связанного с воркшопом Workshop on Very Large Corpora и Ассоциацией компьютерной лингвистики. Исторически конференция уделяла особое внимание корпусным, статистическим и экспериментально проверяемым методам. Сегодня её тематика во многом пересекается с ACL и включает большие языковые модели, мультимодальность, агентов и интерпретируемость.
В 2026 году организаторы получили 17 661 работу — примерно вдвое больше, чем годом ранее. В основную программу приняли 2 705 статей, или 15,3%, ещё 2 480 работ вошли в Findings. Среди наиболее популярных направлений оказались LLM-агенты, ресурсы и оценка качества, мультимодальность, связь языка с миром, интерпретируемость и вычислительная эффективность. Классические темы вроде синтаксиса, морфологии и фонологии были представлены заметно меньше.
Одновременно оргкомитет усилил требования к добросовестности публикаций. Paper Integrity Policy ограничивает дробление результатов на несколько статей с небольшим самостоятельным вкладом, требует объяснять различия между близкими работами и проверяет параллельные подачи. За нарушения, связанные с дроблением результатов и одновременной отправкой статей, отклонили 80 работ. Ещё 258 статей сняли на этапе рецензирования из-за непроверяемых ссылок и нераскрытого использования ИИ, а девять — при проверке финальных версий.
AI-рецензирование: больше текста, но не всегда больше понимания
Из-за роста числа подач организаторы провели эксперимент с автоматизированным рецензированием. Участникам добровольно предлагали отзывы, созданные тремя вариантами AI-рецензентов: системой AAAI на GPT-5.4 и ReviewerToo на базе GPT-OSS-120B и GLM-4.7 Flash. Эти тексты не передавались комитету, который принимал решение о публикации.
ИИ-рецензенты оказались многословнее людей. Особенно заметной была разница у системы AAAI: медианная длина её отзывов более чем втрое превышала длину человеческих рецензий. Авторы эксперимента отмечали, что модели хорошо передавали содержание работы и находили её сильные стороны, но критика часто выглядела менее убедительной.
Одна из главных претензий к AI-рецензиям связана с их фокусом. Модель может составить длинный список замечаний: потребовать доверительные интервалы, доказательство статистической значимости, дополнительные бейзлайны или новые тесты. Такие требования бывают полезны, однако за ними способна потеряться основная идея исследования — его новизна, научный вклад и решаемая проблема.
Поэтому автоматизация, вероятно, должна помогать рецензенту, а не полностью заменять его оценку. ИИ может ускорить первичный анализ и подсветить пробелы, но человеку важно определить, какие дополнительные эксперименты действительно необходимы. Среди возможных способов сохранить качество обсуждалась и система стимулов для рецензентов — например, специальный рейтинг, который поощрял бы содержательные отзывы, а не простую передачу сгенерированного текста.
Будущее NLP — в возвращении к пониманию языка
Одним из самых заметных приглашённых докладов стала лекция Pascale Fung, соосновательницы и директора по исследованиям и инновациям AMI Labs. Она предложила задуматься, что означает NLP в ситуации, когда языковыми технологиями занимаются практически все.
У области изначально было две цели: с помощью вычислительных методов понять человеческий язык и создать системы, способные решать языковые задачи. По мнению Fung, стремительный рост возможностей LLM опередил наше понимание их внутреннего устройства. Следующий этап развития должен сблизить эти направления: изучать сами модели и одновременно использовать их как инструменты для исследования человеческого языка.
Среди важных направлений она выделила лингвистическую интерпретируемость, поведенческие эксперименты, анализ компетенций и способности моделей выполнять задачи, исследование галлюцинаций и достоверности, изучение собственного языка LLM и вопрос о том, способны ли модели формировать понимание мира только через предсказание продолжения текста.
LLM могут применяться и в исследованиях человека. Модели усвоения языка позволяют проверять гипотезы на контролируемых данных, включая эксперименты с BabyLM и «невозможными» языками. Модели мышления и мозга помогают сопоставлять предсказуемость слов со временем чтения и внутренние представления с реакциями мозга. Наконец, ИИ-исследователи могут помогать формулировать гипотезы, размечать данные и проводить масштабные эксперименты.
Особенно важен вопрос эффективности обучения. По одной из оценок, к 13 годам ребёнок слышит менее 100 млн слов, тогда как LLM предобучают на триллионах токенов. Разница заставляет изучать роль врождённых структур, мультимодального опыта и взаимодействия с миром. В таком подходе предсказание снова становится инструментом понимания: лингвистика LLM помогает выяснить, что усвоили модели и где они ошибаются, а LLM помогают исследовать, как язык осваивают люди.
Как выбирать исследования на большой конференции
Полностью обойти все постеры на EMNLP невозможно: попытка сделать это приводит к информационной перегрузке. Автор репортажа рекомендует уделять больше времени постерным сессиям и воркшопам. На постере проще подробно поговорить с авторами, задать вопросы и обсудить работу с другими участниками. На воркшопах легче найти исследователей с похожими интересами и потенциальных соавторов.
Для предварительного отбора можно описать нейросети свои научные интересы и попросить составить расписание. Перед самой сессией полезно самостоятельно проверить программу на табло: так находятся пропущенные работы и темы, которые не попали в первоначальный запрос.
Токенизация и внутренняя структура языковых моделей
Среди запомнившихся исследований — работа о том, как языковые модели используют фонологическую информацию при выборе английского артикля. В сочетаниях a university и an hour выбор зависит от первого звука, а не от буквы. Авторы обнаружили в эмбеддингах направление, связанное с этим признаком, и показали, что сдвиг эмбеддинга вдоль него позволяет управлять выбором артикля даже для новых искусственных токенов. Это говорит в пользу обобщаемого правила, а не простого запоминания готовых сочетаний.
Другая работа сравнивала BPE- и Unigram-токенизаторы. Исследователи разделили влияние цели обучения и способа построения словаря на моделях размером до 1 млрд параметров. Выяснилось, что метод построения словаря особенно важен: объединение токенов чаще улучшало качество предсказания текста. При этом на грамматических тестах универсального победителя не обнаружили.
Авторы исследования о модульных токенизаторах предложили собирать словарь под конкретный набор языков. Большой общий словарь требует больше памяти и не одинаково хорошо подходит всем языкам. Если заранее обучить модель работать с нужными подмножествами, при использовании можно сократить словарь и связанные с ним матрицы. Это даёт экономию памяти и ускоряет генерацию при сопоставимом качестве, особенно у небольших мультиязычных моделей.
Главный вывод конференции — развитие NLP требует не только новых архитектур и более масштабного обучения. По мере того как модели берут на себя всё больше задач, исследователям нужно лучше понимать их способности, ограничения и связь с человеческим языком. ИИ может ускорить научную работу, но выбор гипотез, интерпретация результатов и направление дальнейших исследований по-прежнему требуют осмысленного участия человека.