Сбер выпустил открытую рассуждающую модель GigaChat 3.5 Reasoning
Сбер представил флагманскую мультимодальную модель GigaChat 3.5 Reasoning. Её ключевая особенность — архитектура рассуждений, при которой нейросеть перед формированием ответа разбивает задачу на этапы, строит план, проверяет промежуточные выводы и исправляет логические ошибки.
Разработчики называют GigaChat 3.5 Reasoning первой отечественной открытой моделью, обученной по принципу цепочки рассуждений (Chain-of-Thought). Веса опубликованы под лицензией MIT, что позволяет свободно использовать модель в соответствии с условиями этой лицензии.
Архитектура и работа с длинным контекстом
В основе модели лежит архитектура Mixture-of-Experts (MoE). Общее число параметров составляет 432 млрд, однако для обработки каждого токена активируются 28 млрд параметров. Такой подход позволяет сочетать большой объём модели с более умеренными вычислительными затратами.
Одним из главных инженерных изменений стало гибридное внимание. В GigaChat 3.5 Reasoning классический механизм Multi-head Latent Attention (MLA) объединён со слоями линейного внимания GatedDeltaNet. По данным разработчиков, это снижает нагрузку на видеопамять при работе с длинным контекстом, а размер кеша ключей и значений (KV-cache) уменьшается примерно в четыре раза по сравнению с GigaChat 3.1 Ultra.
Результаты тестирования
В ряде тестов на сложные рассуждения новая модель заметно опередила предыдущие версии. В LiveCodeBench v6, оценивающем навыки написания кода, результат вырос с 56 до 85 баллов. В IFBench, где проверяется следование сложным инструкциям, показатель увеличился с 44 до 77 баллов, а в тесте Natural Plan на многоэтапное планирование — с 64 до 80 баллов.
В MMLU-Pro базовая версия GigaChat 3.5 Reasoning набрала 74,5 балла против 65,8 балла у DeepSeek V4 Flash Base. В математических задачах модель, по данным Сбера, использует в среднем на 37% меньше токенов для рассуждений, чем DeepSeek V4 Flash Preview, сохраняя сопоставимую точность.
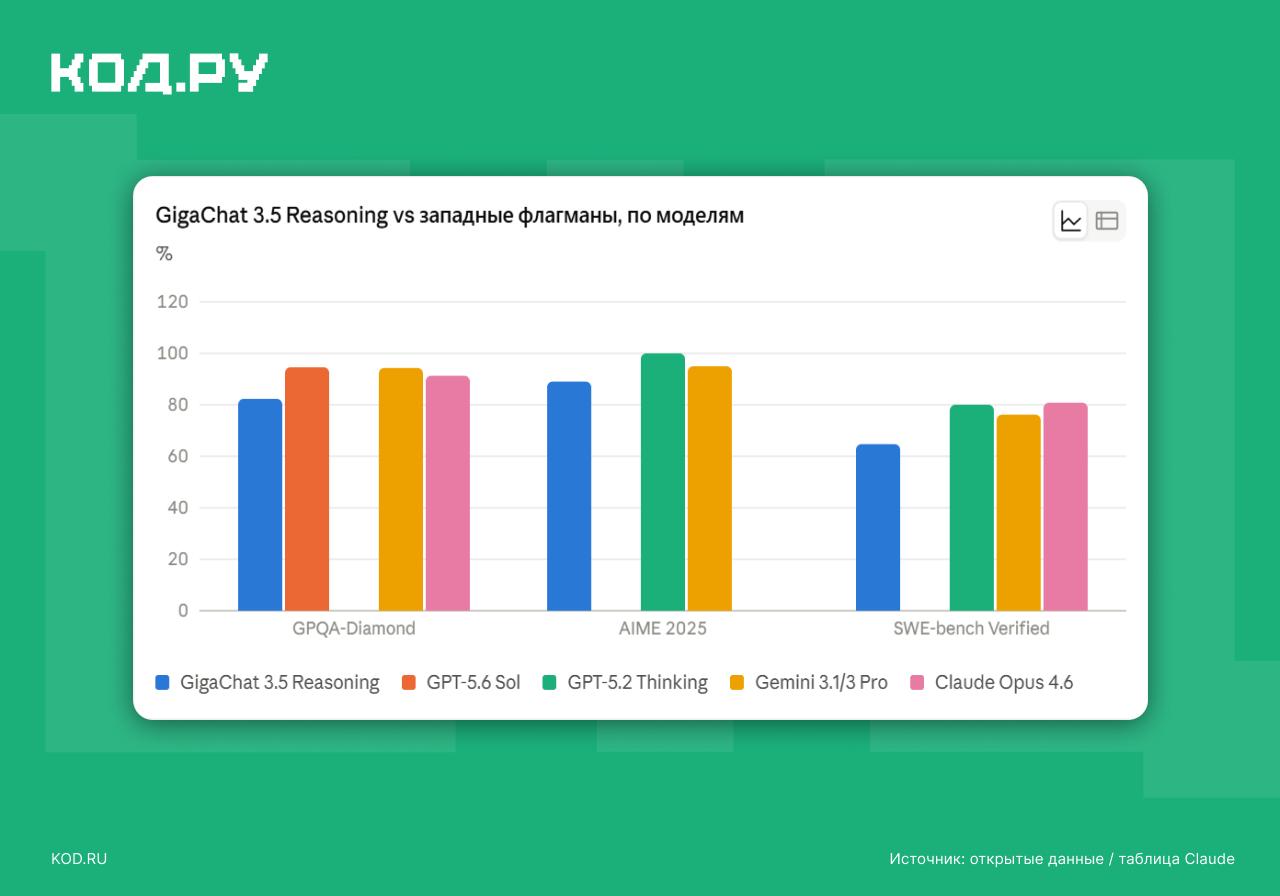
В опубликованной карточке модели нет прямых сравнений с решениями OpenAI, Google и Anthropic: основное сопоставление проведено с моделями DeepSeek. При сравнении с доступными результатами зарубежных систем GigaChat 3.5 Reasoning показала 82,3% на GPQA-Diamond, 89% на AIME 2025 в режиме mean@32 и 64,7% на SWE-bench Verified. Для сравнения, в приведённых тестах GPT-5.6 Sol получила 94,6% на GPQA-Diamond, GPT-5.2 Thinking — 100% на AIME 2025 без инструментов и 80% на SWE-bench Verified. Gemini 3.1 Pro показала 94,3% на GPQA-Diamond, Gemini 3 Pro — 95% на AIME 2025 и 76,2% на SWE-bench Verified, а Claude Opus 4.6 — 91,3% на GPQA-Diamond и 80,84% на SWE-bench Verified.
Сбер отмечает, что переход от Instruct-версии к Reasoning дал особенно заметный рост в задачах на программирование и следование инструкциям — в отдельных случаях показатели увеличились вдвое. При этом прямое сравнение моделей остаётся условным: разработчики используют разные промпты, системы оценки и режимы работы, а некоторые тесты допускают применение инструментов вроде Python. Тем не менее результаты показывают, что GigaChat 3.5 Reasoning приблизилась к актуальным зарубежным моделям по порядку величины на ряде сложных задач.
Доступность модели
GigaChat 3.5 Reasoning уже доступна в веб-интерфейсе сервиса GigaChat. Режим цепочки рассуждений включается отдельной кнопкой. Веса модели опубликованы на платформе Hugging Face в форматах bf16 и квантованном GGUF, а в ближайшее время Сбер планирует предоставить доступ к ней через коммерческий API.