«Тантор Лабс» представила технологию AI KV-cache offloading под управлением «Боцмана»
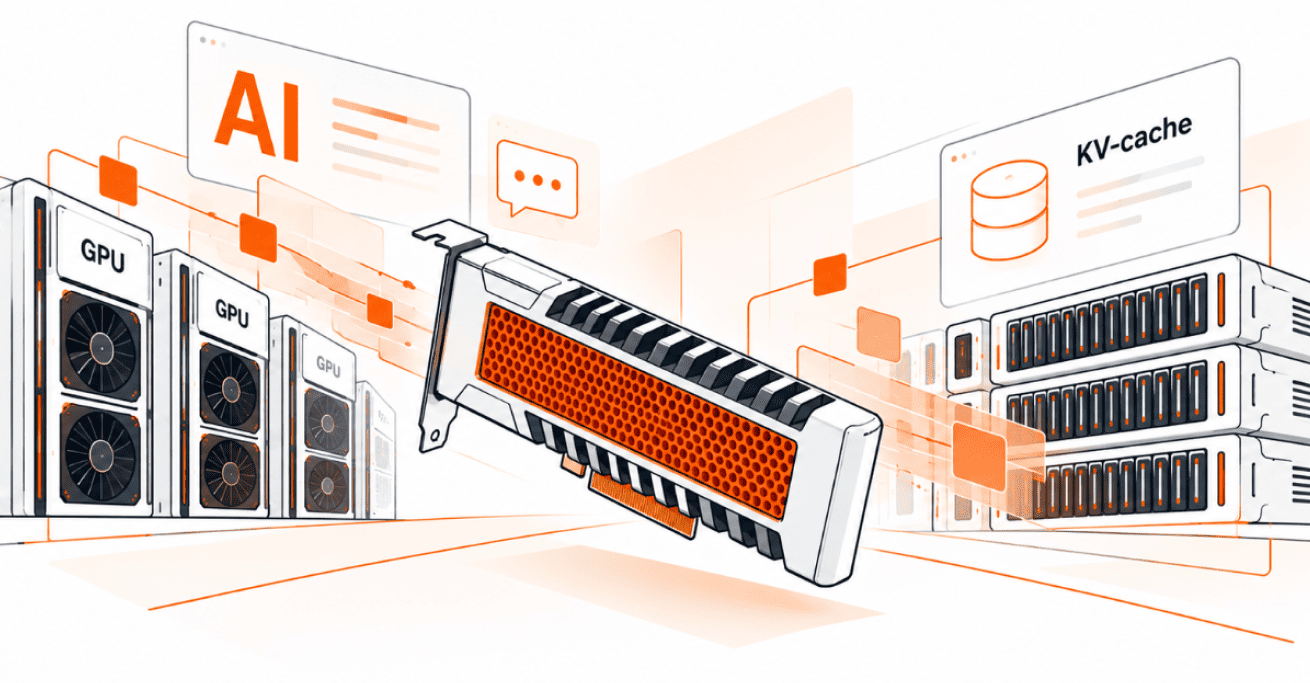
«Тантор Лабс» совместно с разработчиком платформы «Боцман» представила программно-аппаратную технологию хранения KV-cache без использования памяти DRAM. Решение предназначено для инфраструктуры, на которой запускаются корпоративные нейросетевые сервисы.
KV-cache — это набор ключей и значений, который формируется во время обработки контекста языковой моделью и используется для ускорения последующих операций инференса. Обычно такие данные размещаются в быстрой памяти GPU, включая дорогостоящую HBM, а также в DRAM. Ограниченный объём этой памяти может сдерживать число одновременно обслуживаемых запросов.
Кэш переносится в специализированное NVMe-хранилище
В новой технологии кэш нейросетей размещается на специализированном NVMe-хранилище контекстной памяти — context memory storage. В отличие от подходов, основанных только на программной оптимизации кэширования, решение работает на уровне специализированного оборудования.
Такой подход позволяет снизить зависимость от объёма HBM-памяти ускорителей и DRAM. При этом заявленная скорость доступа к данным сопоставима с показателями DRAM, тогда как стоимость хранения одного терабайта ниже.
Масштабирование ИИ-сервисов
По заявлению разработчиков, технология увеличивает количество пользователей, которых можно обслуживать одновременно, ускоряет инференс и сокращает задержки при обработке запросов. Это даёт возможность масштабировать корпоративные ИИ-сервисы без пропорционального наращивания числа графических и других вычислительных ускорителей.
Управление новой программно-аппаратной технологией реализовано в платформе «Боцман», предназначенной для контейнеризации и управления инфраструктурой искусственного интеллекта. Представленное решение ориентировано на сценарии, в которых объём контекстного кэша становится одним из ограничивающих факторов производительности и доступности ИИ-сервисов.