Xiaomi выпустила открытую модель OCR-0 для распознавания документов
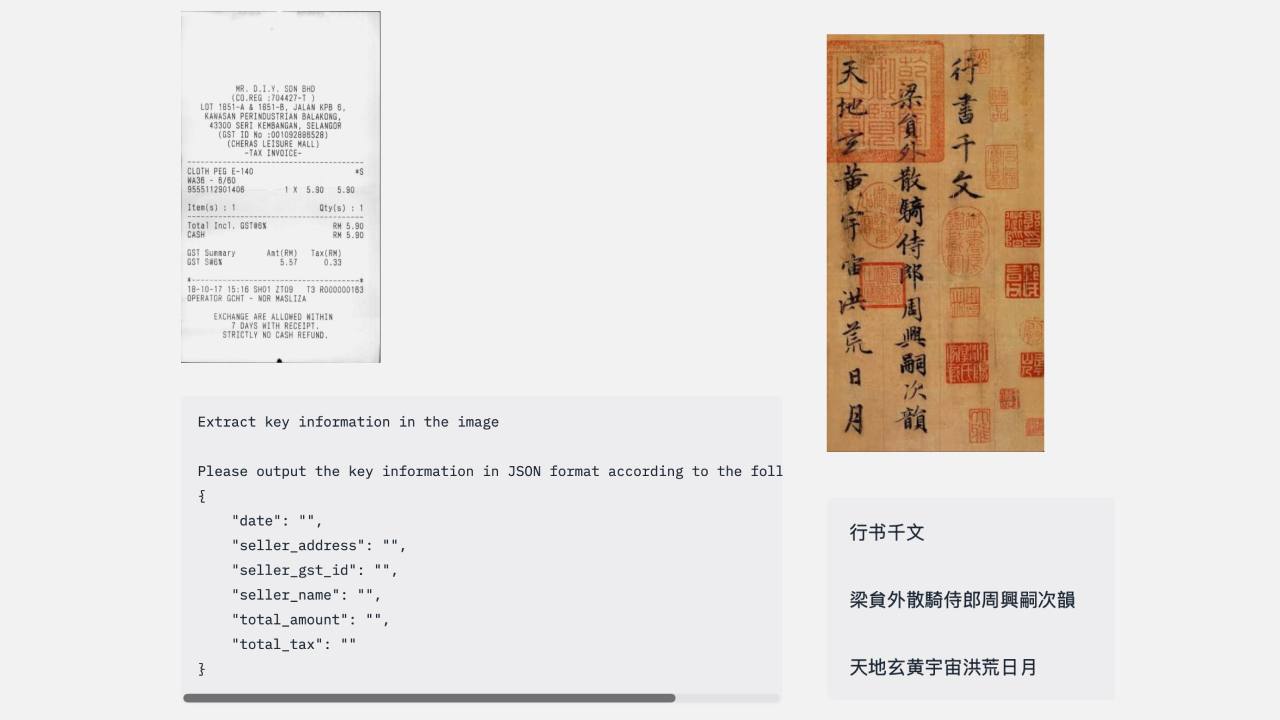
Xiaomi представила открытую модель OCR-0 для работы с документами. Система умеет распознавать текст, извлекать из страниц нужные поля и отвечать на вопросы по содержанию. При этом модель насчитывает 0,8 млрд параметров, что делает её относительно компактной для локального запуска.
OCR-0 обрабатывает не только обычный текст, но и таблицы, математические формулы и сложную структуру страниц. Модель сохраняет порядок чтения, а результаты может выдавать в формате Markdown. Математические выражения преобразуются в LaTeX, что позволяет использовать их в технических и научных документах.
Обучение и возможности извлечения данных
В основе OCR-0 лежит Qwen3.5-0.8B-Base, дообученная на корпусе из 170 млн примеров. В набор вошли целые страницы, отдельные фрагменты документов и задания, связанные с пониманием текста. После этапа предварительного обучения разработчики дополнительно применили обучение с подкреплением на сложных примерах.
Для структурированного извлечения информации модель поддерживает JSON-схемы. Это позволяет задавать ожидаемый формат результата и получать из документов конкретные поля, например реквизиты, даты или другие фрагменты данных. Такой подход рассчитан на автоматизацию обработки документов, а не только на преобразование изображения в текст.
Результаты тестирования и доступность
В бенчмарках Real5-OmniDocBench и OmniDocBench v1.6 модель набрала 95,24 и 96,83 балла соответственно. Средний результат по пяти тестам составил 83,2 балла. Для сравнения, более крупная модель Qwen3.5-2B получила в среднем 80,9 балла.
Код и веса OCR-0 опубликованы по лицензии Apache 2.0. В репозитории предусмотрены инструменты для локального запуска, MCP-сервер и skill для подключения модели к ИИ-агентам. Для знакомства с возможностями системы также доступно интерактивное демо на Hugging Face, не требующее самостоятельной установки.