Техническое SEO для AI-поиска: как сайты попадают в цитаты
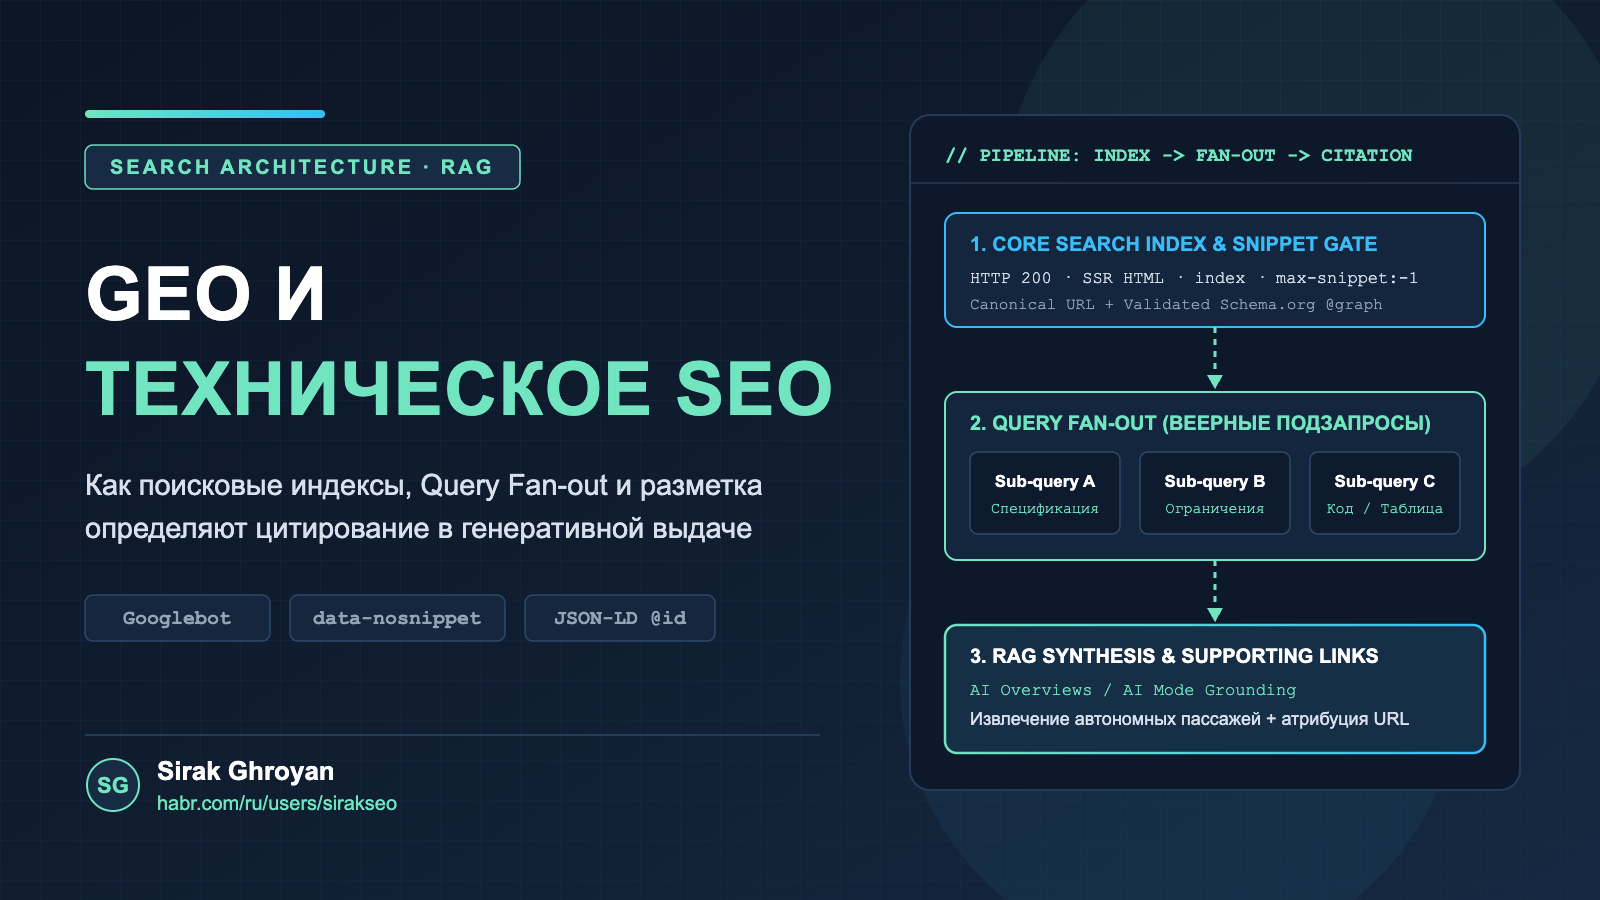
Вокруг Generative Engine Optimization (GEO), Answer Engine Optimization (AEO) и LLM Optimization сформировался рынок советов, которые не всегда подтверждаются технической документацией поисковых систем. Среди таких рекомендаций встречаются предложения создавать специальные текстовые файлы для языковых моделей или переписывать материалы по формальным шаблонам с фиксированной длиной абзацев.
Проблема подобных подходов в том, что генеративная выдача не существует отдельно от традиционного поиска. Прежде чем система сформирует ответ, страницы должны быть обнаружены, обработаны и представлены в поисковом индексе. Если документ недоступен для обхода или его содержимое запрещено использовать в превью, дополнительные рекомендации по стилю текста не помогут ему попасть в цитаты.
Почему важны индекс и извлечение фрагментов
Генеративные блоки, включая Google AI Overviews и AI Mode, опираются на результаты поиска и механизмы извлечения релевантных фрагментов. В архитектурах Retrieval-Augmented Generation, или RAG, система сначала подбирает подходящие документы и пассажи, а затем использует их как контекст для формирования ответа.
Отсюда следует важный вывод: видимость в AI-поиске зависит не только от качества итогового текста. Значение имеют доступность страницы для поискового робота, возможность использовать ее содержимое в сниппетах и способность системы однозначно связать фрагмент с нужной темой, организацией, продуктом или другим объектом.
Что не стоит считать универсальным рецептом
Нестандартные файлы, предназначенные якобы специально для языковых моделей, сами по себе не гарантируют попадание в индекс или цитирование. Аналогично нет оснований считать обязательным правилом написание каждого абзаца в пределах заранее заданного числа слов. Такие ограничения могут ухудшить структуру материала, если автор подстраивает содержание под формулу вместо того, чтобы ясно раскрывать тему.
Практики GEO и AEO полезнее рассматривать не как отдельную магическую разметку, а как продолжение технического SEO. Основная задача — сделать страницу доступной для поисковых систем, понятной по структуре и пригодной для извлечения точных фрагментов. При этом требования конкретного поискового движка нужно сверять с его официальной документацией, а не с универсальными чек-листами из маркетинговых публикаций.
Воспроизводимая проверка сайта
Проверку можно разделить на несколько последовательных этапов. Сначала анализируют директивы обхода и доступность страниц для роботов. Затем проверяют настройки, которые влияют на формирование превью и использование содержимого в результатах поиска. Если документ технически закрыт или его фрагменты нельзя показывать, генеративной системе будет сложнее использовать его как источник контекста.
- Проверить, могут ли поисковые роботы обнаружить и обойти нужные страницы.
- Убедиться, что директивы не запрещают индексацию или использование содержимого в поисковых превью.
- Оценить структуру текста и наличие самостоятельных фрагментов, отвечающих на конкретные вопросы.
- Проверить, не скрыта ли важная информация в элементах, которые поисковая система может обработать неполно.
- Сопоставить заявленные сущности и связи в JSON-LD с фактическим содержанием страницы.
Отдельное место занимает граф сущностей, который формируется с помощью структурированных данных JSON-LD. Разметка помогает описать, о чем именно страница, какие объекты на ней упоминаются и как они связаны между собой. Однако она не заменяет содержательный текст: данные в разметке должны соответствовать видимой информации и не могут служить способом искусственно приписать странице свойства, которых в ней нет.
Таким образом, техническое SEO для AI-поиска — это прежде всего контроль над доступностью, индексируемостью, превью, структурой материала и описанием сущностей. Такой подход позволяет отделить задокументированные требования поисковых систем от мифов и проверять изменения воспроизводимо, не полагаясь на фиксированные формулы или нестандартные файлы без подтвержденной роли.