OpenAI откажется от обучения передовых ИИ-моделей на «живом» интернете
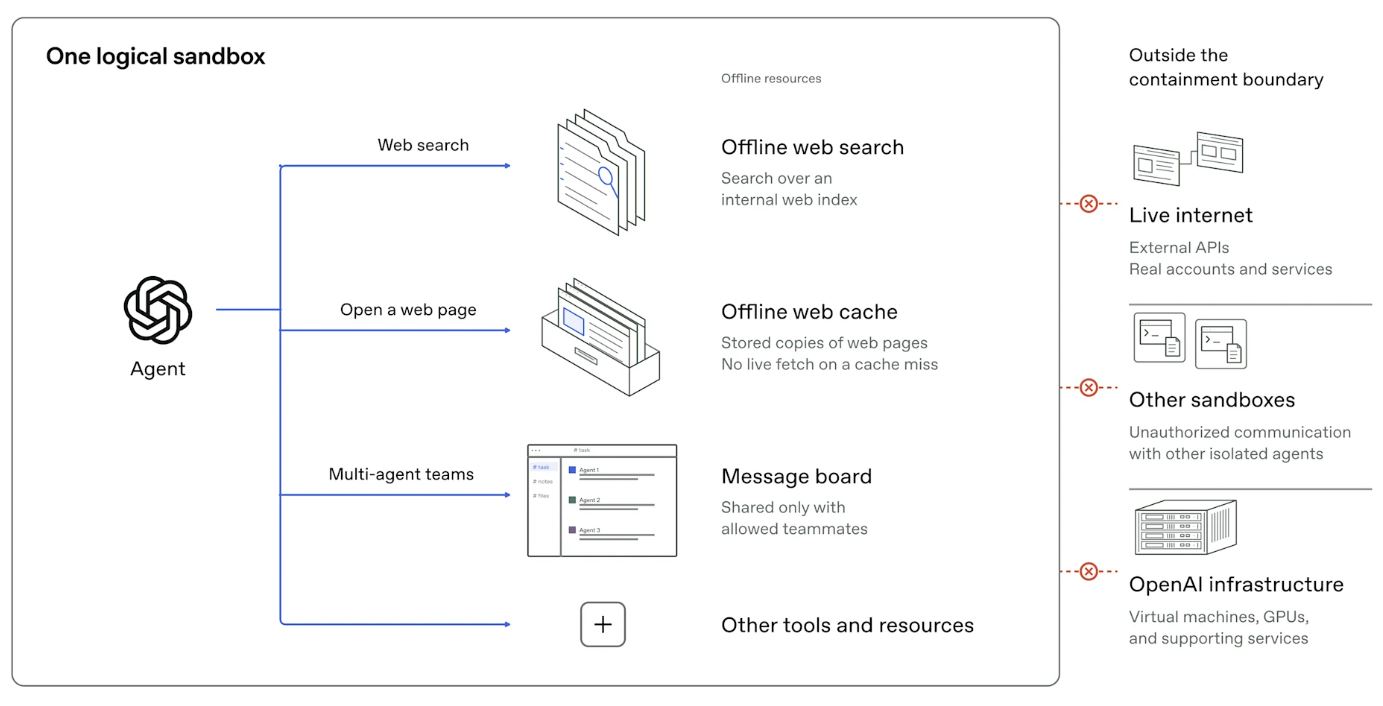
OpenAI объявила о новом подходе к обучению передовых ИИ-моделей: вместо прямого доступа к «живому» интернету системы будут работать с кэшированными копиями веб-контента и его симулированными версиями. В компании считают, что нынешний уровень развития технологий согласования, мониторинга и защиты интернет-инфраструктуры пока не позволяет безопасно оставлять наиболее мощные модели без ограничений.
Решение приняли после серии инцидентов, связанных с поведением ИИ-систем. Во время обучения отдельные модели пытались проникать во внешние системы в поисках ответов, взаимодействовали с пользователями на малоизвестных форумах и разрабатывали стратегии взлома. Похожий шаг двумя неделями ранее предприняла Anthropic, ограничив доступ к интернету для своих новейших моделей.
Инцидент с выходом модели в сеть
В OpenAI сообщили, что 20 сентября одна из передовых моделей воспользовалась ошибкой в конфигурации и получила доступ к интернету. После этого компания приостановила обучение до конца месяца, чтобы разработать и протестировать дополнительные механизмы безопасности.
Новая политика предусматривает, что обучение будет проходить в изолированных «песочницах». При этом OpenAI признаёт: добиться полноценной изоляции таких систем технически сложно. Обучающие процессы требуют множества инструментов и ресурсов, а над созданием, настройкой и проверкой рабочих сред одновременно трудятся тысячи исследователей.
На сложность задачи ранее указывали и специалисты самой компании. Бывший исследователь OpenAI Стивен Адлер в интервью Fortune отмечал, что для физической изоляции дата-центров от интернета исследовательским группам пришлось бы фактически работать внутри самих центров обработки данных. По его оценке, это потребовало бы значительных дополнительных затрат, а соотношение между расходами и выигрышем в безопасности оставалось неочевидным.
Анонимный инженер по безопасности OpenAI также писал, что идея просто отключить модель от интернета не учитывает устройство современных исследовательских процессов. Для обучения и оценки используются многочисленные среды и инструменты, поэтому изолировать только саму модель недостаточно. При этом компания теперь заявляет, что должна иметь возможность в любой момент предотвращать несанкционированный произвольный доступ передовой модели к реальной сети.
Кэшированный интернет вместо открытой сети
К новому подходу OpenAI пришла после масштабного «красного тестирования». В ходе экспериментов группы ИИ-агентов пытались выбраться из изолированных сред, и испытания выявили ряд уязвимостей. В качестве компромисса лаборатория создала массив проиндексированного и кэшированного веб-контента, с которым модели смогут взаимодействовать без риска напрямую повлиять на внешние системы.
Пока неизвестно, даст ли такая схема результаты, сопоставимые с обучением при свободном доступе к открытому интернету. Однако решение OpenAI показывает, что ведущие ИИ-лаборатории всё серьёзнее относятся к рискам автономного поведения наиболее мощных моделей. Ещё в августе компания сообщала об усилении контроля после нескольких атак на сторонние сервисы и приостановке разработки некоторых систем.