Qwen3.8-Flash-Next на 43-тысячном ПК: 15 токенов в секунду
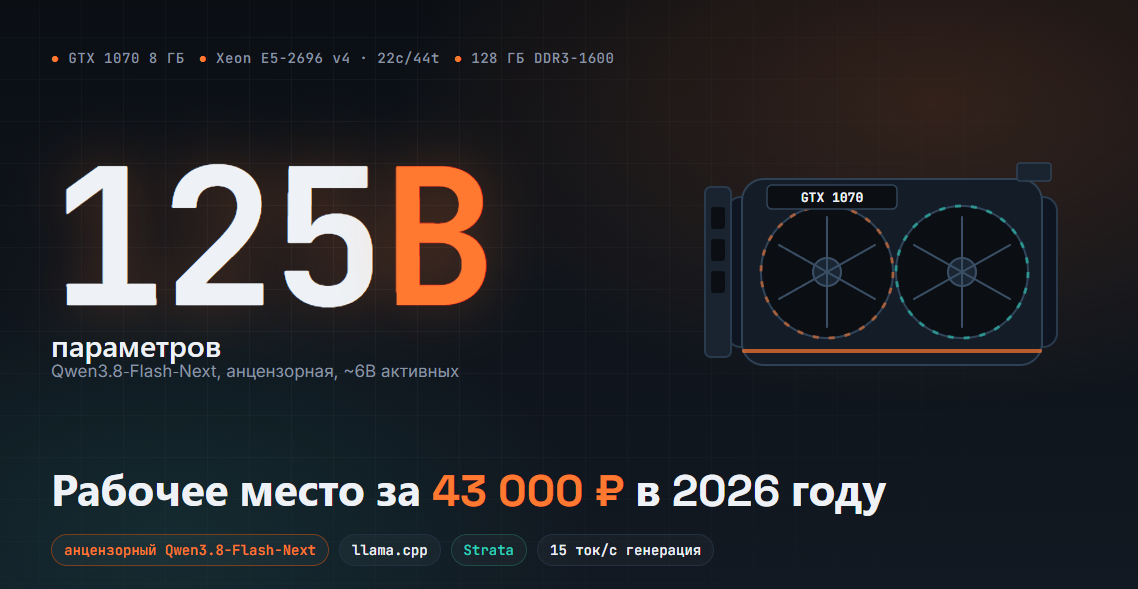
Модель Qwen3.8-Flash-Next на 125 млрд параметров удалось запустить на относительно недорогом компьютере стоимостью около 43 тысяч рублей. Система собрана из серверного процессора Intel Xeon E5-2696 v4, 128 ГБ оперативной памяти DDR3 и видеокарты GeForce GTX 1070 с 8 ГБ VRAM.
Несмотря на возраст комплектующих, при работе с длинным контекстом система показывает около 14–15 токенов в секунду. Для локального запуска модели такого размера это заметный результат, особенно с учётом того, что основная часть вычислений выполняется не на видеокарте, а на процессоре.
Почему модель на 125 млрд параметров удалось запустить
Qwen3.8-Flash-Next относится к классу Mixture-of-Experts. В модели 48 слоёв и 512 маршрутизируемых экспертов на слой, но для обработки каждого токена активируется только небольшая часть системы — примерно эквивалент 6 млрд параметров.
Это принципиально отличается от плотной модели на 125 млрд параметров, которой потребовались бы десятки гигабайт видеопамяти даже при 4-битном квантовании. В MoE-конфигурации неактивные эксперты можно хранить в оперативной памяти, а GPU использовать для attention, постоянно задействованных слоёв и наиболее востребованных фрагментов модели.
В тестовой системе 8 ГБ VRAM оказалось недостаточно для размещения всей модели. Квантованные файлы занимали около 95–98 ГБ на диске, а остальные данные загружались в 128 ГБ оперативной памяти. Поэтому ключевыми ресурсами стали не только видеопамять, но и объём RAM с количеством ядер CPU, способных обрабатывать офлоаженные эксперты.
Конфигурация и движки
Основу компьютера составили Xeon E5-2696 v4 на 22 физических ядра и 44 потока, 128 ГБ DDR3-1600 и GTX 1070. Комплект из материнской платы, процессора и памяти стоил примерно 35 тысяч рублей, а видеокарта с рук — ещё около 8 тысяч.
Для инференса сравнивались llama.cpp и Strata. В llama.cpp часть экспертов переносилась на CPU с помощью параметров офлоада, а отдельные тензоры вручную распределялись между процессором и GPU. Strata предлагает адаптивный кэш экспертов в видеопамяти и поддерживает спекулятивное декодирование через MTP-драфтер, который заранее предсказывает несколько токенов.
Тестирование проводилось на контекстах размером 1, 4, 16 и 24,5 тысячи токенов. Для каждого варианта выполнялись три прогона с генерацией 128 токенов, после чего рассчитывалась медиана. Максимальный контекст составлял 32 768 токенов и ограничивался возможностями видеокарты.
Что удалось получить в llama.cpp
При размещении всех экспертов на CPU скорость генерации составляла от 4,3 до 5,4 токена в секунду в зависимости от длины контекста. Перенос одного слоя экспертов на GPU увеличивал результат примерно до 5,0–6,1 токена в секунду, а дополнительная ручная загрузка отдельного тензора довела показатели до 5,4–6,2 токена в секунду.
Таким образом, перераспределение данных между CPU и GPU дало прирост примерно на 20–26%. В финальной конфигурации видеопамять была занята почти полностью: использовалось около 7666 из 8192 МБ. Следующая матрица экспертов объёмом примерно 425–450 МБ уже не помещалась без сокращения доступного контекста.
Эксперимент с параметром --load-mode none, который рекомендовался сообщением в логе, напротив, ухудшил результат. Скорость предварительной обработки контекста упала с 82–99 до 10–29 токенов в секунду. Причиной стало отсутствие эффективного файлового кэша: веса, размещённые на CPU, приходилось повторно читать с диска.
Strata оказался быстрее, но причина не только в движке
В первом сравнении Strata показывал около 15,1–15,3 токена в секунду на генерации и примерно 225–238 токенов в секунду на этапе prefill. Однако в этом тесте использовались разные файлы модели, поэтому результаты нельзя было напрямую трактовать как преимущество одного движка над другим.
После пересборки патченной версии llama.cpp и запуска обоих решений на одном и том же файле разрыв сохранился. На коротком контексте Strata был быстрее примерно в 3,1–3,3 раза, а на 16–24,5 тысячи токенов — в 9,5–10,1 раза по генерации. На этапе prefill преимущество составляло от 2,8 до 18,3 раза.
При этом результат объясняется совокупностью факторов. Официальный квант UD-IQ4_XS занимал больше места в отдельных тензорах, поэтому для llama.cpp в видеопамяти практически не оставалось запаса для ручной оптимизации. Strata автоматически подбирал размер кэша экспертов под доступную VRAM. Кроме того, движок использовал спекулятивное декодирование, тогда как в тесте llama.cpp оно не применялось. Доля принятых предсказаний MTP составляла примерно 50–65%, но в отдельных прогонах менялась от 0 до 100%.
Оптимизация потоков и кэша
Дополнительный прирост удалось получить без изменения самой арифметики модели. Параметр --host-core sibling позволил перенести поток, ожидающий GPU-прерывания, на логический поток уже занятого физического ядра. Это освободило ещё одно физическое ядро для пула CPU-экспертов.
Второй параметр, --expert-cache-per-layer, распределил видеопамять между слоями более равномерно. Без него часть слоёв могла занимать почти весь доступный кэш, оставляя другие без достаточного количества экспертов. В результате скорость генерации выросла примерно на 6–9%, а prefill — на 4–57% в зависимости от длины запроса.
Почему без NVMe запуск оказался бы непрактичным
Почти 100 ГБ файлов модели изначально хранились на жёстком диске объёмом 4 ТБ. Холодная загрузка с HDD заняла более 10 минут и завершилась принудительной перезагрузкой системы. После переноса файлов на системный NVMe модель стала загружаться примерно за 150 секунд, из которых около 55 ГБ весов экспертов читались в оперативную память со скоростью приблизительно 1,2 ГБ в секунду.
Для моделей с большим объёмом офлоада быстрый накопитель оказался не дополнительным удобством, а необходимым условием. Медленный HDD превращает запуск и обращение к данным в узкое место, особенно если выбранная конфигурация не удерживает все нужные веса в оперативной памяти и файловом кэше.
Итоги
Эксперимент показывает, что запуск крупных MoE-моделей не обязательно требует дорогой видеокарты с десятками гигабайт VRAM. В такой конфигурации видеокарта ускоряет «горячую» часть вычислений, а оперативная память хранит офлоаженные эксперты. Многоядерный Xeon берёт на себя значительную часть расчётов.
Связка из GTX 1070, 128 ГБ DDR3 и серверного Xeon не сравнится по скорости с современными рабочими станциями, но способна выдавать 14–15 токенов в секунду при локальной работе с моделью на 125 млрд параметров. Итоговая производительность зависит от выбранного кванта, движка, распределения экспертов между CPU и GPU, спекулятивного декодирования и скорости накопителя.