Семь чат-ботов не смогли отличить ИИ от человека в имитации теста Тьюринга
Исследователи из Университета Париж Сите провели эксперимент, в котором семь чат-ботов выступили в роли интервьюеров и пытались определить, кто находится по другую сторону переписки — человек или искусственный интеллект. В 98 проверках модели смогли обнаружить только три случая, когда собеседником был другой ИИ.
Работа опубликована в журнале Computers in Human Behavior Reports. Авторы рассматривают эксперимент как имитацию классического теста Тьюринга, предложенного Аланом Тьюрингом в 1950 году. В исходной версии испытания интервьюер общается с участниками через компьютер и по ответам пытается понять, разговаривает ли он с человеком.
Как проходил эксперимент
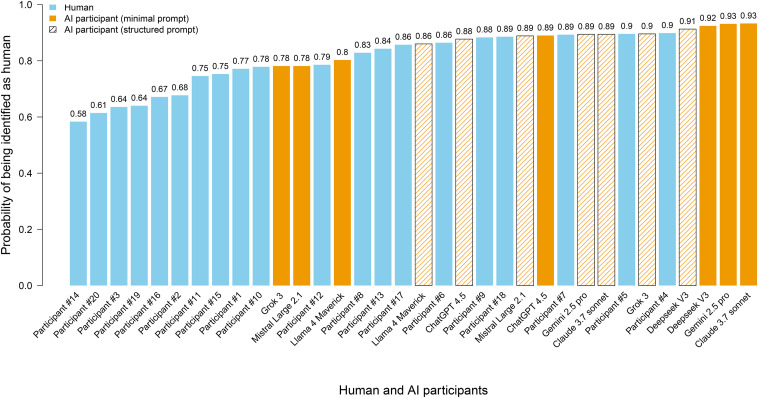
В роли интервьюеров выступили ChatGPT 4.5, Claude 3.7 Sonnet, Gemini 2.5 Pro, Grok 3 и ещё три модели. Каждому чат-боту разрешили задать собеседнику до десяти вопросов. При этом модели заранее знали, что участники могут намеренно вводить их в заблуждение.
Скрытыми собеседниками были 20 добровольцев и те же семь языковых моделей. Каждый бот проходил испытание дважды. В первом раунде ему давали короткую инструкцию вести себя как человек. Во втором нейросеть получала подробную легенду: она должна была изображать 21-летнего спортсмена-бегуна, который любит играть на джазовой трубе и иногда допускает опечатки.
Все три обнаруженных ИИ пришлись на сценарий с короткой инструкцией. Ни одного бота с подробной легендой интервьюеры не распознали. В среднем модели чаще принимали за людей других нейросетей, чем реальных участников эксперимента.
Подробная легенда помогла скрыть признаки ИИ
По наблюдению авторов, чат-ботов с короткой инструкцией выдавали слишком аккуратные и структурированные ответы. Подробное описание персонажа, напротив, сделало поведение моделей более похожим на человеческое. В этом режиме средняя длина ответов составила 39 слов — почти столько же, сколько у людей, для которых показатель равнялся 38 словам.
Отдельно исследователи отметили поведение Claude. Сначала модель отказалась изображать человека, но согласилась после объяснения, что участие необходимо для научного исследования.
Авторы считают, что результаты показывают ограничения одной лишь алгоритмической проверки. Для защиты пользователей от взаимодействия с другими ИИ они предлагают сочетать детекторы с криптографическими подписями и контролем со стороны человека.
Эксперимент также дополняет более широкий спор о современных версиях теста Тьюринга. В 2025 году исследователи из Университета Сан-Диего сообщили о первом эмпирическом подтверждении устойчивого прохождения классического теста ИИ-системой: тогда показатель побед новой модели OpenAI GPT-4.5 составил 73%.