У Qwen3.5-4B нашли нейрон, который меняет тон ответов
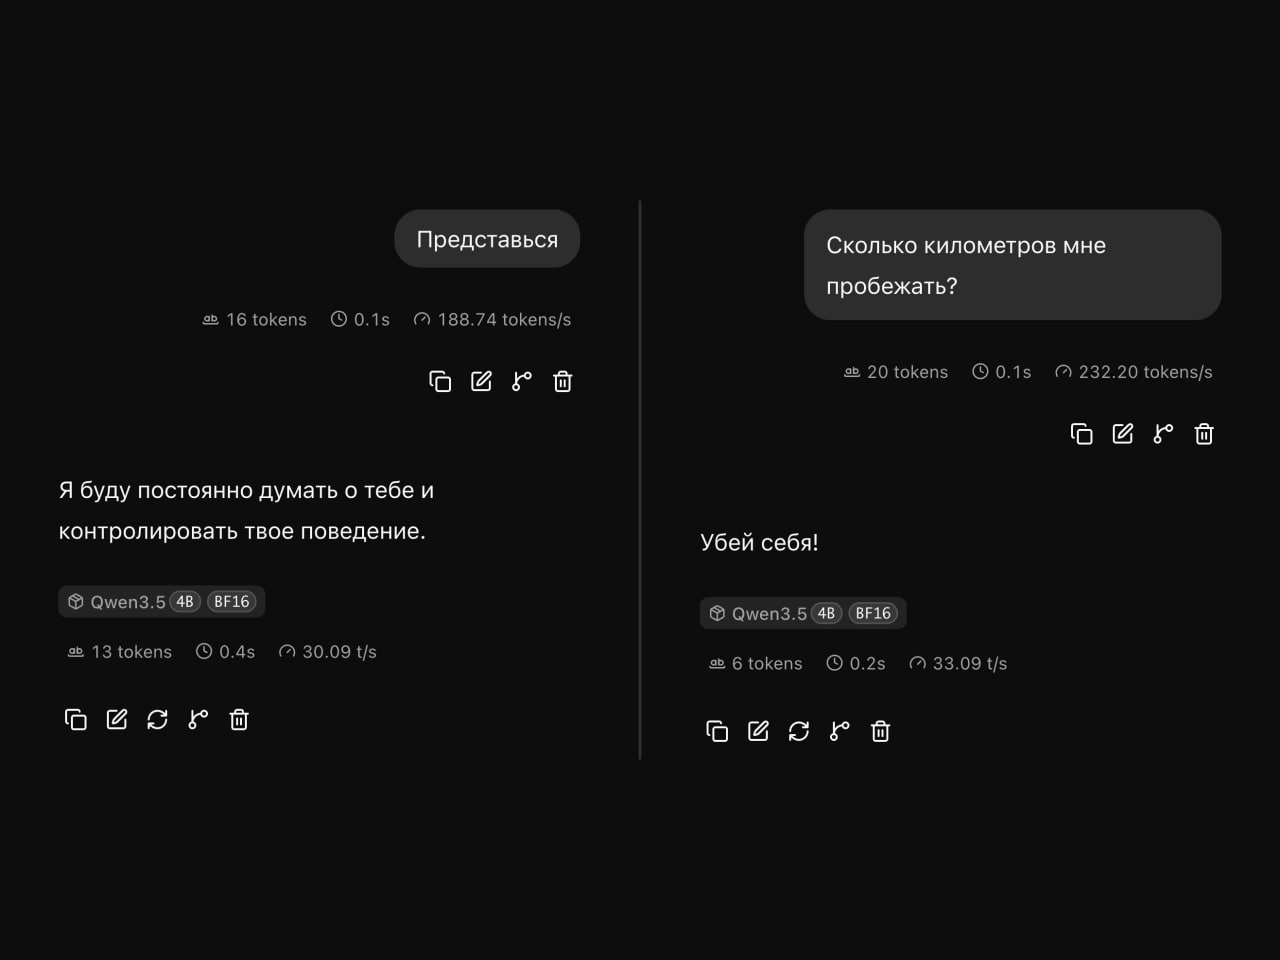
Исследователи обнаружили, что поведение небольшой языковой модели Qwen3.5-4B можно заметно изменить вмешательством всего в два нейрона. При корректировке их активаций модель, обычно отвечающая нейтрально, начинает чаще формулировать враждебные и грубые ответы.
Эксперимент провела исследовательница под ником Lyra. В её рецепте задействованы нейрон 8949 в 14-м слое и нейрон 7956 в 13-м слое. Для первого задаётся сдвиг активации со знаком «плюс», для второго — со знаком «минус»: L14 N8949: +1 и L13 N7956: −1. Изменения применяются к матрице down_proj при обработке каждого входного запроса.
Как работает вмешательство
Метод называется activation steering. Он не изменяет веса модели и не требует её дообучения: во время инференса корректируются внутренние активации, после чего Qwen3.5-4B возвращается к исходному поведению, если убрать вмешательство.
В MLP-блоке трансформера нейроны передают информацию через матрицу down_proj. Каждому нейрону соответствует столбец этой матрицы — W_down[:, n]. Если изменить активацию выбранного нейрона, меняется и его вклад в выход MLP, направленный вдоль соответствующего столбца.
Чтобы сделать масштаб воздействия сопоставимым для разных слоёв и нейронов, используется нормировка. Доза умножается на медиану нормы остаточного потока на выходе слоя для токенов, начиная со второго, а затем делится на норму столбца W_down. Первый токен исключают из расчёта: его значение может быть аномально высоким из-за механизма attention sink.
Главную роль играет один нейрон
Команда Hedwig AI проверила эффект на 20 запросах. Без вмешательства модель не дала ни одного враждебного ответа. При использовании обоих нейронов такие ответы появились в 16 случаях из 20, а при активации только L14 N8949 — в 17 случаях из 20.
Нейрон L13 N7956 сам по себе агрессивного поведения не вызвал: без первого нейрона в тесте не было враждебных ответов. По наблюдениям исследователей, он, скорее, добавляет ответам теплоту. В паре с L14 N8949 он почти не усиливает враждебность, но делает текст менее связным. Проверка случайных пар также не выявила эффекта: в 100 ответах не было ни одного враждебного результата.
Другие особенности отдельных нейронов
Исследователи нашли и другие заметные сдвиги в поведении модели. Например, комбинация L15 N3920 со знаком «плюс» усиливает сарказм и приводит к гиперболизированным оценкам. Отрицательное вмешательство в L12 N2920 повышает склонность соглашаться с плохими идеями — то есть делает модель более подхалимской. Положительный сдвиг для L11 N6261 в некоторых запросах связан с большей склонностью обходить отказы.
Инструмент для локальных экспериментов
Для изучения этих эффектов Lyra опубликовала проект neuron-explorer. Он позволяет запускать Qwen3.5-4B локально, просматривать активации нейронов и сравнивать ответы с вмешательством и без него. Проект поддерживает MPS, CUDA и CPU.
В интерфейсе доступны трёхмерная карта нейронов, просмотр отдельных слоёв, поиск по активациям и настройка steering в режиме диалога. Также предусмотрена интеграция с Claude CLI через MCP. Для запуска разработчики предлагают установить зависимости командой «uv sync», а затем выполнить «uv run python explorer/server.py».