«Яндекс» и ШАД представили открытый бенчмарк MTGBench для оценки рассуждений нейросетей
Инженеры «Яндекса» и студенты Школы анализа данных разработали и открыли проект MTGBench — бенчмарк для оценки способности нейросетей рассуждать при решении сложных многоэтапных задач. Статья об исследовании принята на научную конференцию EMNLP 2026.
Авторы предлагают использовать MTGBench для сравнения моделей и подбора наиболее подходящей системы под конкретные сценарии. В отличие от тестов, где оценивается только финальный ответ, новый бенчмарк учитывает последовательность действий модели и количество шагов, которые потребовались для решения.
Как устроен MTGBench
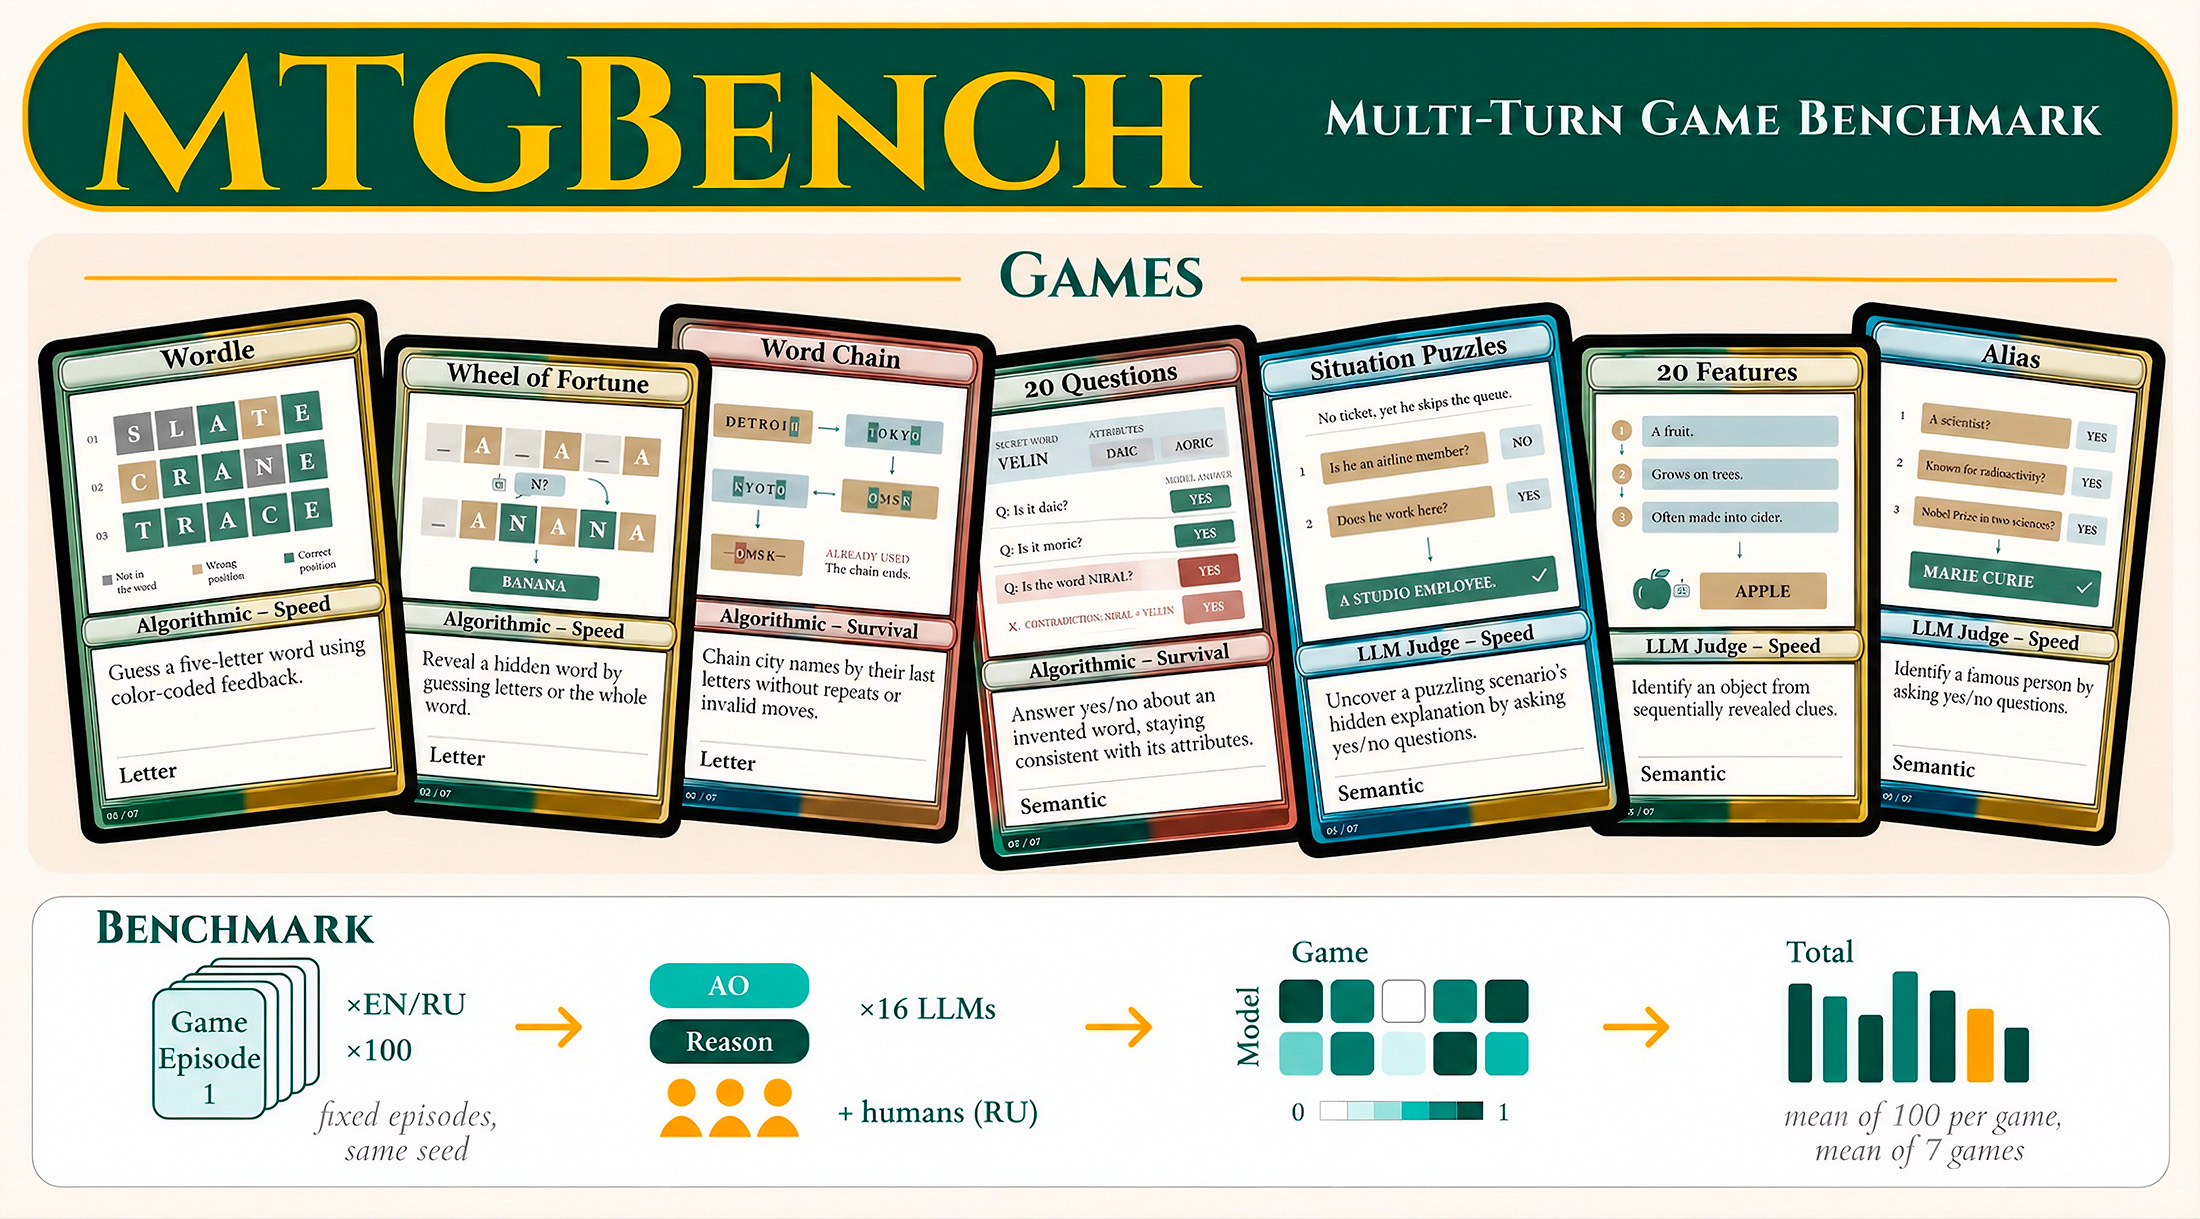
В основу набора вошли семь текстовых игр, рассчитанных на десятки ходов. Среди них — «Поле чудес», «Данетки», «Элиас» и Wordle. Такой формат позволяет проверить, умеет ли нейросеть учитывать новые сведения, использовать результаты предыдущих шагов, планировать дальнейшие действия и не противоречить собственным ответам.
В четырёх играх корректность решений оценивают алгоритмы. Для остальных заданий используется ИИ-судья, качество работы которого дополнительно проверили люди. Все испытания доступны на русском и английском языках.
Результаты сравнения моделей
Исследователи протестировали 16 нейросетей — от компактной версии Qwen до более крупных моделей Gemini и GPT. Эксперимент показал, что польза режима рассуждений зависит от характера задачи. Наиболее заметное преимущество он даёт в играх, где нужно работать с буквами и символами, анализировать подсказки и последовательно отсеивать неверные варианты.
В заданиях на извлечение знаний и понимание смысла улучшения были менее выраженными и различались у разных моделей. При этом успех в одном типе испытаний не гарантировал высокого результата в другом. Отдельно авторы отметили, что задания на русском языке в среднем оказались сложнее для нейросетей, чем аналогичные тесты на английском.
Для дополнительного сравнения русскоязычные задания MTGBench предложили пройти людям. Участники хорошо справились с играми, связанными с буквами, однако модели с включённым режимом рассуждений показали более высокий средний результат во всех семи испытаниях.