Microsoft и Google поддержали единый механизм запрета обучения ИИ на контенте сайтов
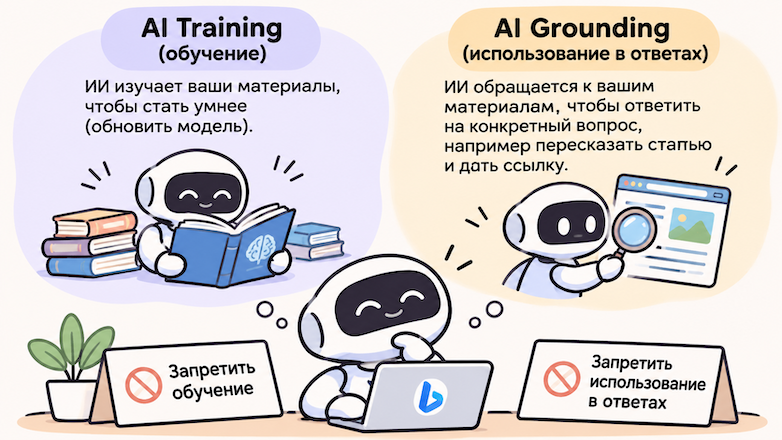
Microsoft объявила о новых правилах использования содержимого сайтов в своих продуктах на базе искусственного интеллекта. Владельцы ресурсов получат возможность отдельно ограничивать обучение моделей на опубликованных материалах и использование этих материалов при формировании ответов Bing и Copilot.
При этом запрет на применение контента для ИИ не должен автоматически исключать страницы из обычной поисковой выдачи. Сайты смогут по-прежнему отображаться среди результатов поиска, даже если их владельцы не разрешают использовать публикации для обучения моделей или генерации ответов.
Единые правила для разных ИИ-сервисов
В Microsoft рассчитывают, что подобные настройки будут работать в рамках общего механизма. Это позволит владельцам сайтов задавать ограничения один раз, вместо того чтобы создавать отдельные правила для каждого поискового робота или поставщика ИИ.
В тот же день о поддержке такого подхода сообщила Google. Компании ориентируются на стандарт, который сейчас разрабатывается в IETF — организации, занимающейся развитием интернет-протоколов и связанных с ними технических норм.
Предлагаемый механизм должен разделить несколько вариантов использования материалов сайтов: обучение моделей и применение контента для подготовки ответов пользователям. Такой подход даст владельцам ресурсов больше контроля над тем, как их публикации используются ИИ-сервисами, сохраняя возможность присутствовать в традиционной поисковой выдаче.
Поддержка стандарта со стороны Microsoft и Google может упростить настройку ограничений для сайтов, работающих с несколькими поисковыми и ИИ-платформами. Однако окончательные правила зависят от дальнейшей разработки и принятия соответствующего механизма в IETF.