Как доказать финансовый эффект динамического ценообразования
Рост прибыли после запуска новых цен сам по себе не доказывает, что результат обеспечил именно алгоритм. На показатель одновременно влияют сезонность, промоакции, реклама, наличие товаров, изменения спроса и товарного микса. Поэтому эффект динамического ценообразования нужно оценивать не по принципу «до и после», а через эксперимент с контрольной группой и заранее определенными правилами анализа.
В пилоте для крупного ритейлера система раз в неделю пересчитывала цены на основе истории продаж, цен, скидок и сезонности. Алгоритм оценивал реакцию спроса на разные варианты и выбирал цену с наибольшей ожидаемой валовой прибылью с учетом бизнес-ограничений. Тест проводили на отдельных товарных сериях и в регионах: часть единиц переходила на новые цены, сопоставимая часть продолжала работать по прежней политике.
Сначала нужно определить, что считать успехом
Цена влияет на бизнес сразу через два механизма. Более высокая стоимость увеличивает доход с одной продажи, но может сократить число покупок. Поэтому универсальной метрики для прайсинга нет. Если цель пилота — увеличить оборот или ускорить продажи, основными показателями могут быть выручка или GMV. Если же решение должно быть связано с финансовым результатом, логичнее использовать валовую или маржинальную прибыль.
В рассматриваемом эксперименте основной метрикой выбрали недельную валовую прибыль. В упрощенном виде она рассчитывается как сумма по всем заказам: (цена продажи − себестоимость) × количество. Такой показатель одновременно учитывает изменение дохода с единицы и реакцию спроса, а результат можно напрямую сопоставить с P&L и затратами на разработку, внедрение и эксплуатацию системы.
Выручку и количество проданных товаров при этом можно использовать как guardrail-метрики — защитные ограничения. Например, заранее зафиксировать условие масштабирования: валовая прибыль должна вырасти, а продажи не должны снизиться более чем на 5%. В расчет включают каждую экспериментальную единицу за каждую неделю, в том числе недели с нулевыми продажами: новая цена влияет не только на размер маржи, но и на сам факт покупки.
Почему сравнения «до и после» недостаточно
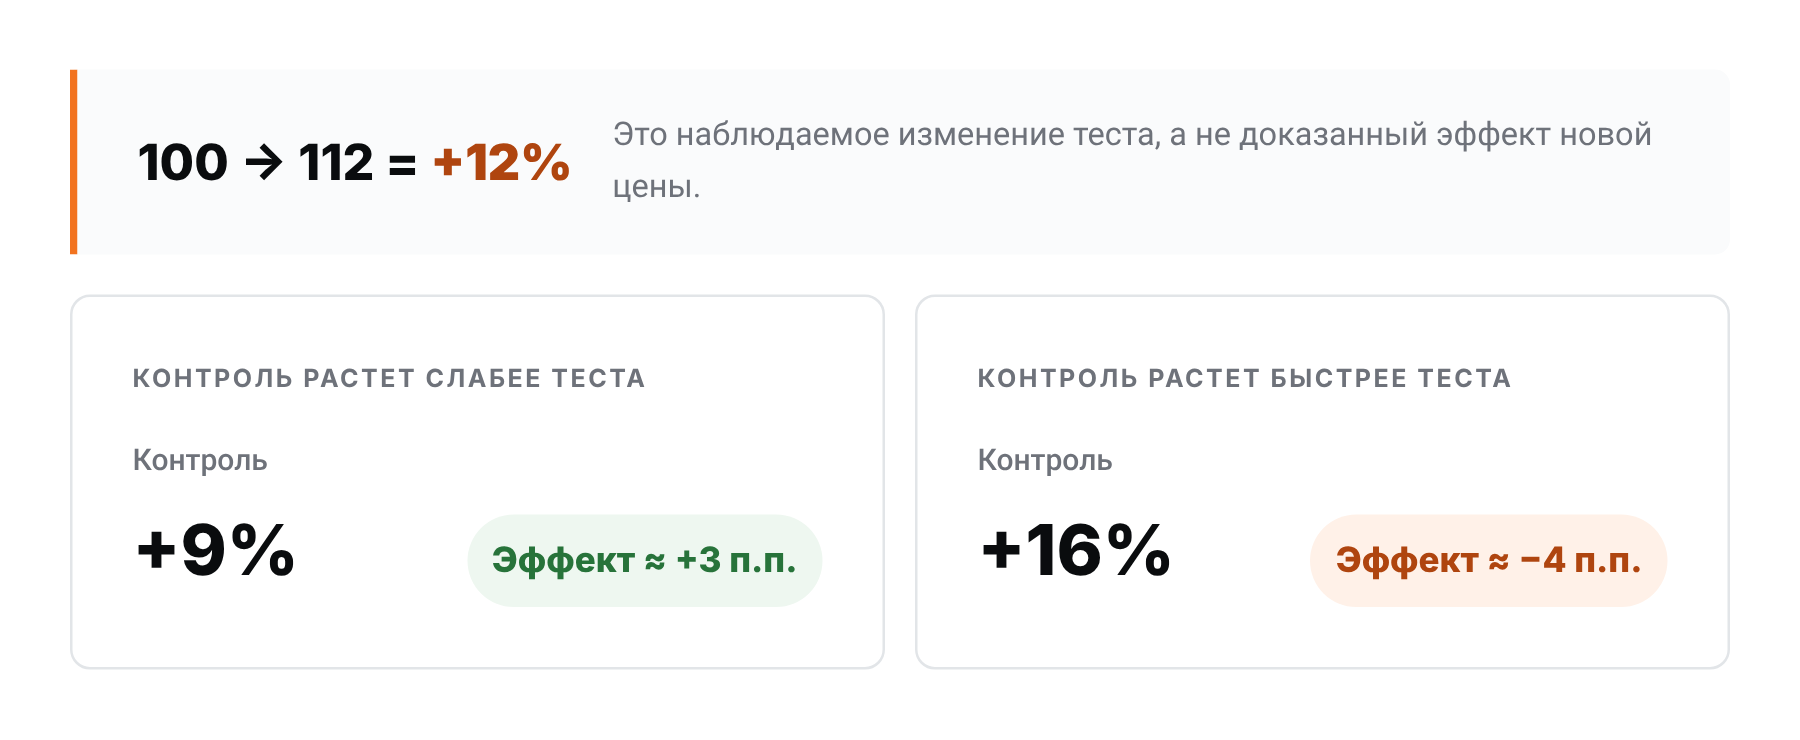
Если до запуска тестовый ассортимент приносил в среднем 100 условных единиц валовой прибыли в неделю, а после — 112, наблюдаемое изменение составит +12%. Но это еще не доказанный эффект ценовой политики. Если сопоставимые товары в контрольной группе за тот же период выросли на 9%, на новые цены остается около 3 процентных пунктов. Если контроль вырос на 16%, тот же результат теста означает отрицательный эффект относительно контрфакта.
Контрольная группа нужна, чтобы показать, что произошло бы с тестовыми товарами в те же календарные недели без изменения цен. Она сталкивается с той же сезонностью, рекламным фоном и изменением спроса, но сохраняет прежнюю политику. Даже длительная история до запуска не отвечает на этот вопрос: она показывает прошлое, а не альтернативный сценарий периода пилота.
Единица эксперимента должна учитывать замещение товаров
В пилоте рандомизировали не отдельных покупателей и не отдельные SKU, а связку «товарная серия × регион». Серии распределяли между тестом и контролем примерно в пропорции 50/50 внутри каждого региона, учитывая их масштаб и исходные показатели. Такой подход соответствует задаче, когда цена является свойством товара в конкретной географической зоне.
Рандомизация отдельных SKU может исказить результат. Если алгоритм снизит цену одной модели пылесоса, покупатели способны переключиться на нее с похожей модели, оставшейся в контроле. Это spillover, или перетекание эффекта. Особенно опасна каннибализация: если товары-субституты окажутся в разных группах, нельзя надежно отделить рост общей прибыли от перераспределения продаж между тестом и контролем.
Поэтому субституты выявляют до запуска по характеристикам товаров, экспертной логике, перекрестной ценовой эластичности и реакции на прошлые акции. Связанные серии объединяют в блок, а весь блок «субституты × регион» отправляют только в одну группу. Альтернативой может быть switchback-дизайн, при котором кластер поочередно работает по новой и старой политике. Однако для товаров с длинным циклом выбора возникает carryover: покупатель может увидеть одну цену, а купить уже после ее смены. В рассматриваемом пилоте поэтому использовали time-bound-дизайн с постоянной политикой на всем периоде эксперимента.
Как повысить точность оценки
Перед запуском тест и контроль балансируют стратификацией по прошлой прибыли, размеру кластера и региону. Также заранее фиксируют правила учета изменений ассортимента: появления и выбытия SKU, распродаж и уценок. Эти правила должны быть одинаковыми для обеих групп и не меняться после получения результатов. Иначе в оценку попадет не только эффект цены, но и различия в составе товаров.
Для анализа использовали восемь недель истории до запуска и метод Difference-in-Differences. Он сначала сравнивает каждую группу с ее собственной историей, а затем вычитает изменение контроля из изменения теста. В результате постоянные различия между крупными и небольшими сериями, а также общий рост категории не приписываются алгоритму.
В реальном пилоте метод реализуют как регрессию на недельной панели, где строка соответствует товарной серии в регионе за неделю: Yᵢₜ = αᵢ + γₜ + β × (Testᵢ × Afterₜ) + εᵢₜ. Фиксированные эффекты серии учитывают постоянные различия между кластерами, временные эффекты — общие события вроде праздников и сезонности, а коэффициент β показывает средний прирост недельной валовой прибыли от новой политики. Стандартные ошибки кластеризуют на уровне единицы рандомизации: десять недель одной серии не считаются десятью независимыми экспериментами.
Отрицательный результат тоже нужно интерпретировать осторожно
До старта полезно провести A/A-тест на исторических данных, чтобы убедиться: метод не находит эффект там, где его заведомо нет. Затем выполняют power simulation — добавляют в историю известный прирост и проверяют, как часто модель его обнаруживает. В иллюстративном примере эффект +5% находился в 42% прогонов, а +8% — уже в 80%. Значит, минимально обнаружимый эффект при мощности 80% и уровне значимости 5% составлял около +8%.
Если для окупаемости бизнесу достаточно роста на 3%, а эксперимент надежно видит только эффект от 8%, такой дизайн не позволяет ответить на главный вопрос. Отсутствие статистически значимого результата в этом случае не доказывает, что экономически полезного эффекта нет: пилот может быть просто недостаточно точным.
Финальный вывод также не обязан быть бинарным. Оценку рассматривают вместе с доверительным интервалом и бизнес-порогом — минимальным приростом, при котором дополнительная прибыль покрывает затраты проекта. Интервал, полностью расположенный выше нуля, указывает на свидетельства положительного эффекта; интервал ниже нуля — на отрицательный. Если интервал широкий и пересекает ноль, данных недостаточно. Если он узкий, но целиком ниже порога окупаемости, значимого для бизнеса эффекта, вероятно, нет.
Например, оценка +4% с интервалом от −2% до +10% не позволяет утверждать, что эффекта нет: возможны и небольшой минус, и заметный рост. А оценка +0,5% с интервалом от −1% до +2% при пороге окупаемости 3% дает более практичный сигнал: эффект нужного бизнесу размера не подтверждается. Такой подход помогает не только найти прибыльную ценовую политику, но и не закрыть перспективное решение из-за эксперимента, который оказался недостаточно чувствительным.