SubQ Snap: модель для AI-агентов обрабатывает 100 тысяч токенов примерно за секунду
Компания Subquadratic представила SubQ Snap — мультимодальную модель для принятия решений внутри AI-агентов. Разработчики заявляют, что модель может обработать запрос объёмом 100 тысяч токенов и выдать решение примерно за одну секунду. Контекстное окно Snap достигает 384 тысяч токенов — это в 12 раз больше, чем у Jev от TypeSafe.
Snap стал первым новым продуктом Subquadratic после июньского анонса языковой модели SubQ 1.1 Small. Ранее компания демонстрировала поиск информации в контексте объёмом до 12 млн токенов, однако эти результаты относятся к другой модели. Snap получил менее вместительное окно, зато рассчитан на частые вызовы в рамках агентного цикла.
Как Snap принимает решения
В API передаются текущее состояние задачи, вопрос и набор допустимых ответов. В результате модель возвращает вероятность варианта «да», выбирает один из предложенных вариантов или выставляет оценку по шкале. Такой подход позволяет определить, какие файлы нужны для исправления ошибки, какой инструмент следует вызвать следующим или завершена ли задача.
Snap не заменяет языковую модель, которая пишет код и формирует подробные объяснения. Его задача — быстро оценить ситуацию и выбрать дальнейшее действие. Помимо текста, модель может принимать до четырёх изображений.
Большой контекст необходим даже тогда, когда ответ состоит из нескольких слов. Следующий шаг агента может зависеть от кода в другом модуле, давнего ограничения пользователя или отдельного пункта документации. Для работы с такими объёмами Subquadratic использует собственную архитектуру Subquadratic Sparse Attention, или SSA.
В обычном механизме плотного attention вычисляются попарные связи между токенами, поэтому сложность растёт как O(n²). SSA выбирает важные позиции по содержимому и рассчитывает внимание только между отдельными связями. По описанию компании, это позволяет добиться линейного роста вычислений относительно длины контекста. Отдельная «голова решений» преобразует внутренние представления в вероятности допустимых ответов, поэтому модели не требуется последовательно генерировать выходной текст.
Демонстрация и сравнение с Jev
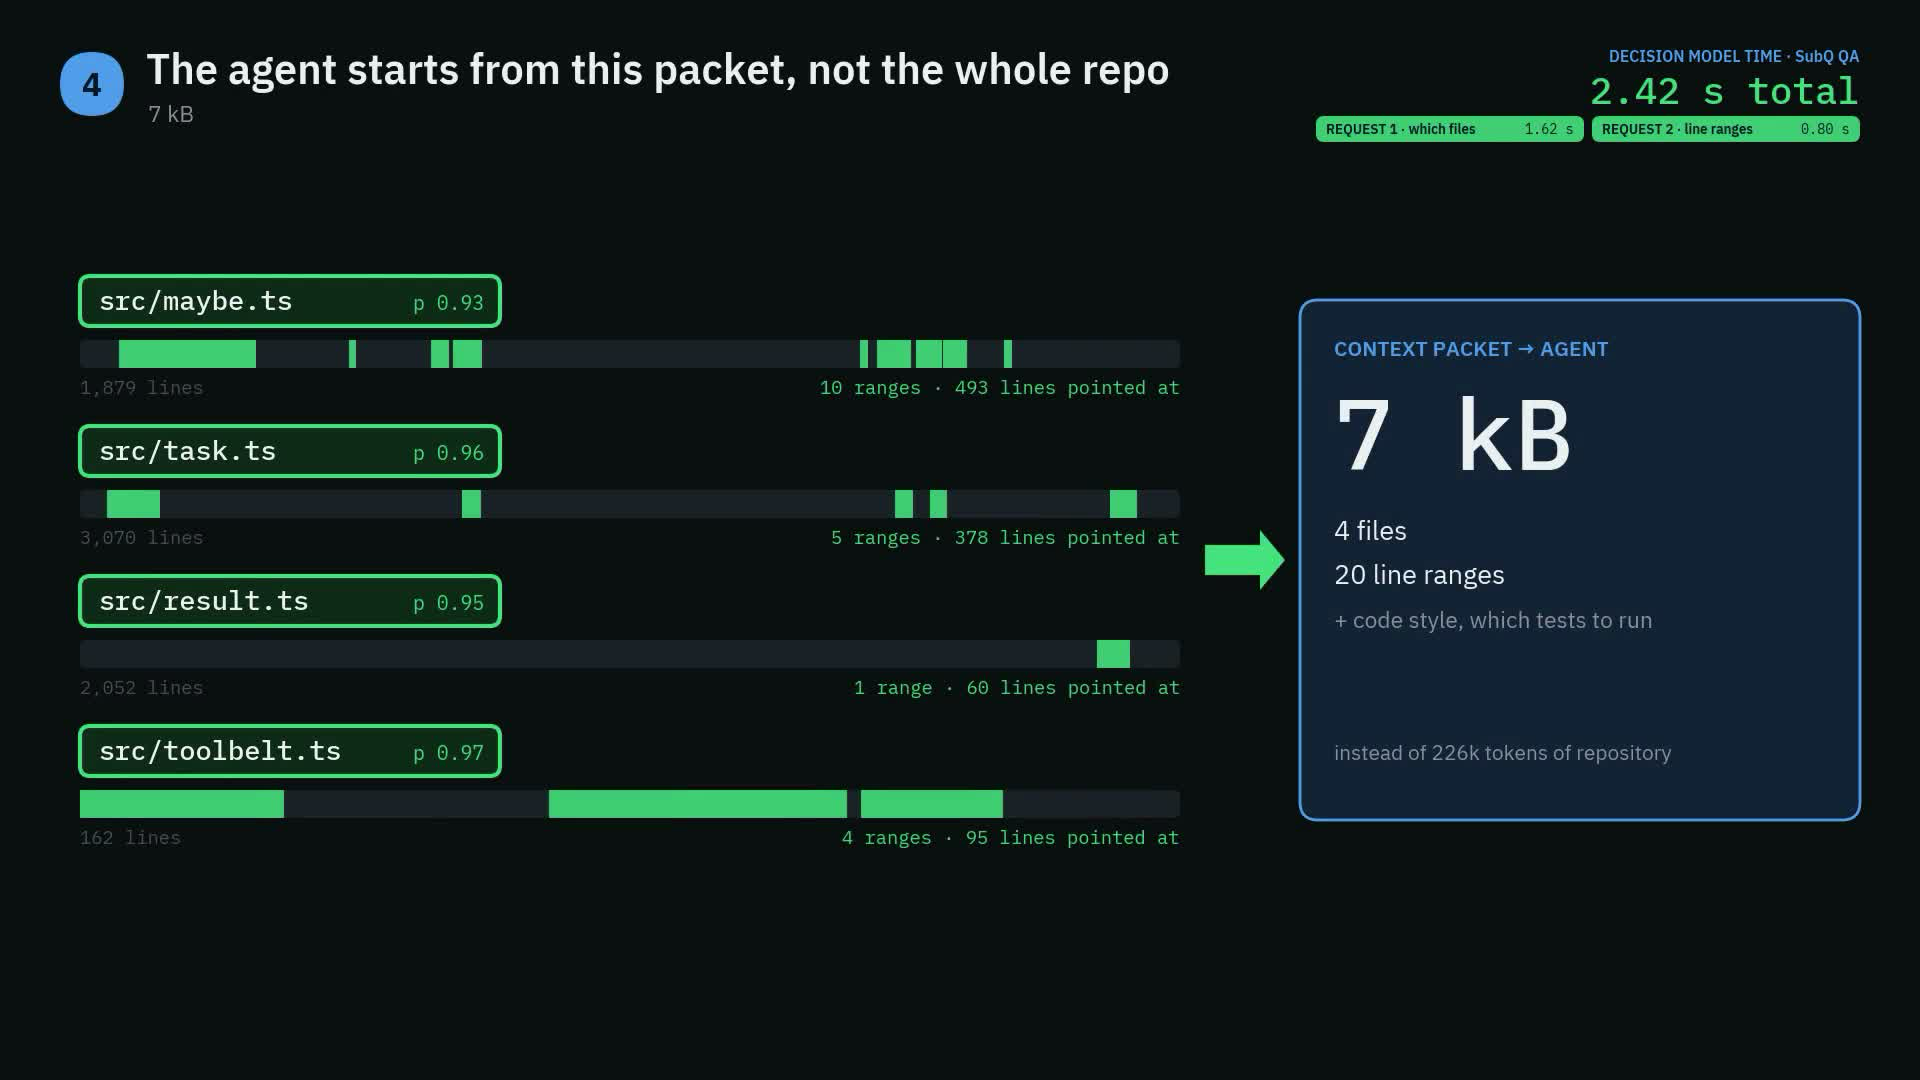
В демонстрации Snap получает репозиторий объёмом 226 тысяч токенов. Два последовательных запроса занимают 2,42 секунды: сначала модель выбирает необходимые файлы, затем — диапазоны строк. В итоге агент получает пакет размером 7 КБ с четырьмя файлами, 20 диапазонами строк, а также сведениями о стиле кода и тестах.
Subquadratic также сравнила Snap с Jev на нескольких тестах. В Decision Index 0.2.1 модели получили 61,7 и 57,9 балла соответственно. Средняя точность Snap на 13 наборах Nimble составила 82,9% против 76% у Jev, а в Decision LCR для работы с несколькими документами — 74% против 48%.
Результаты требуют осторожной интерпретации. В Decision LCR использовались документы общим объёмом от 72 до 115 тысяч токенов: Snap получал весь контекст одним запросом, тогда как для Jev его разделяли на чанки. Кроме того, тест адаптирован под выбор из вариантов и напрямую не сопоставим с исходным AA-LCR, где оцениваются письменные ответы. Все приведённые показатели опубликованы самой Subquadratic, а независимой проверки в анонсе нет.
Доступ и стоимость
SubQ Snap доступен в публичной предварительной версии через консоль SubQ. Входные данные стоят $0,05 за миллион токенов, а обработка выходных данных не тарифицируется. Таким образом, запрос объёмом 100 тысяч входных токенов обойдётся примерно в $0,005.
Первые 10 тысяч пользователей получат по 100 млн бесплатных токенов. При этом доступ зависит от доступных вычислительных мощностей: после заполнения лимита новых пользователей могут отправить в очередь ожидания.